Meeting Agent
简体中文 | English
接入你的智能体
從發布者安裝。不是 PlugMCP 端點。
遠端 URL 還是本機指令? 兩種安裝方式的差異
來自發布者
简体中文 | English
A full-stack multimodal meeting intelligence system with layered RAG, long-term memory, and skill-based generation.
Meeting Agent 是一个全栈 RAG 应用:它可以接收会议录音、文档、文本/数据文件和图像,完成转录或解析,将规范化内容写入语义与词法索引,并提供带引用的问答、对话记忆、知识图谱实体跟踪以及可选的 Web 搜索增强。准确的文件扩展名与处理器支持矩阵以摄取管线文档为准。
**文档状态:**维护中的指南和架构参考已于 2026-09-10 根据源码树、OpenAPI 契约、Compose 拓扑和 Alembic 迁移链完成核对。带日期的审计报告仍作为历史证据保留;请从 docs/README.md 进入当前文档导航。
由 35 张精选截图制作的动态导览,包含聊天流程及长回答的后续画面,展示素材管理、PDF/幻灯片与视频预览、限定范围的带引用问答、历史记录、Memory、设置,以及基于 Skill 的文档生成。每个画面均留有阅读时间;播放节奏不代表应用的实际响应速度。
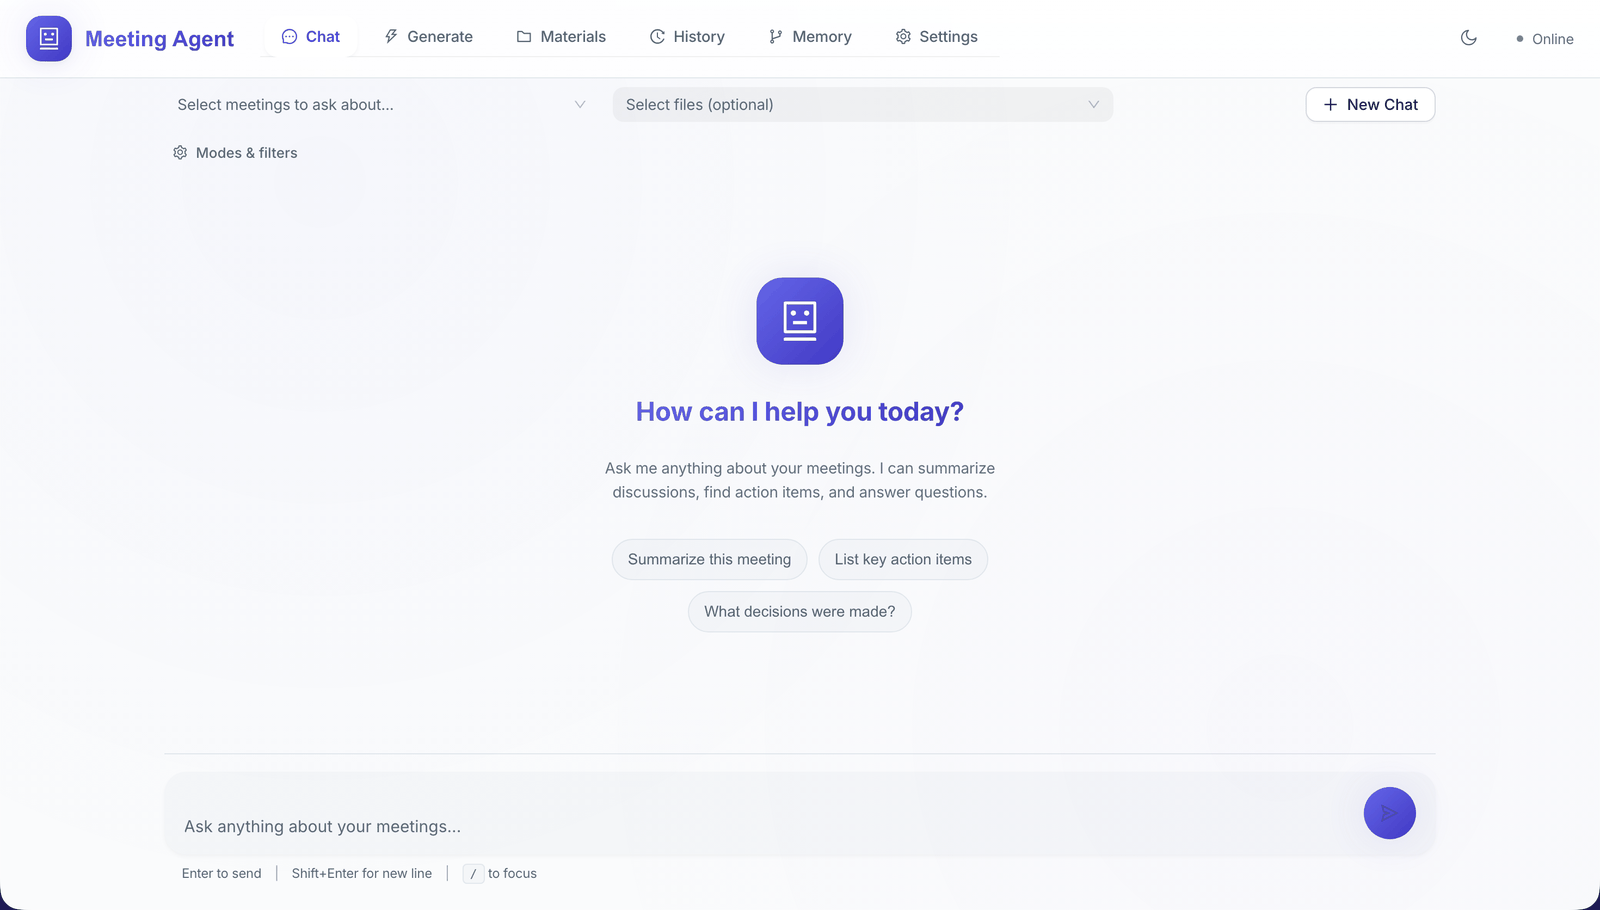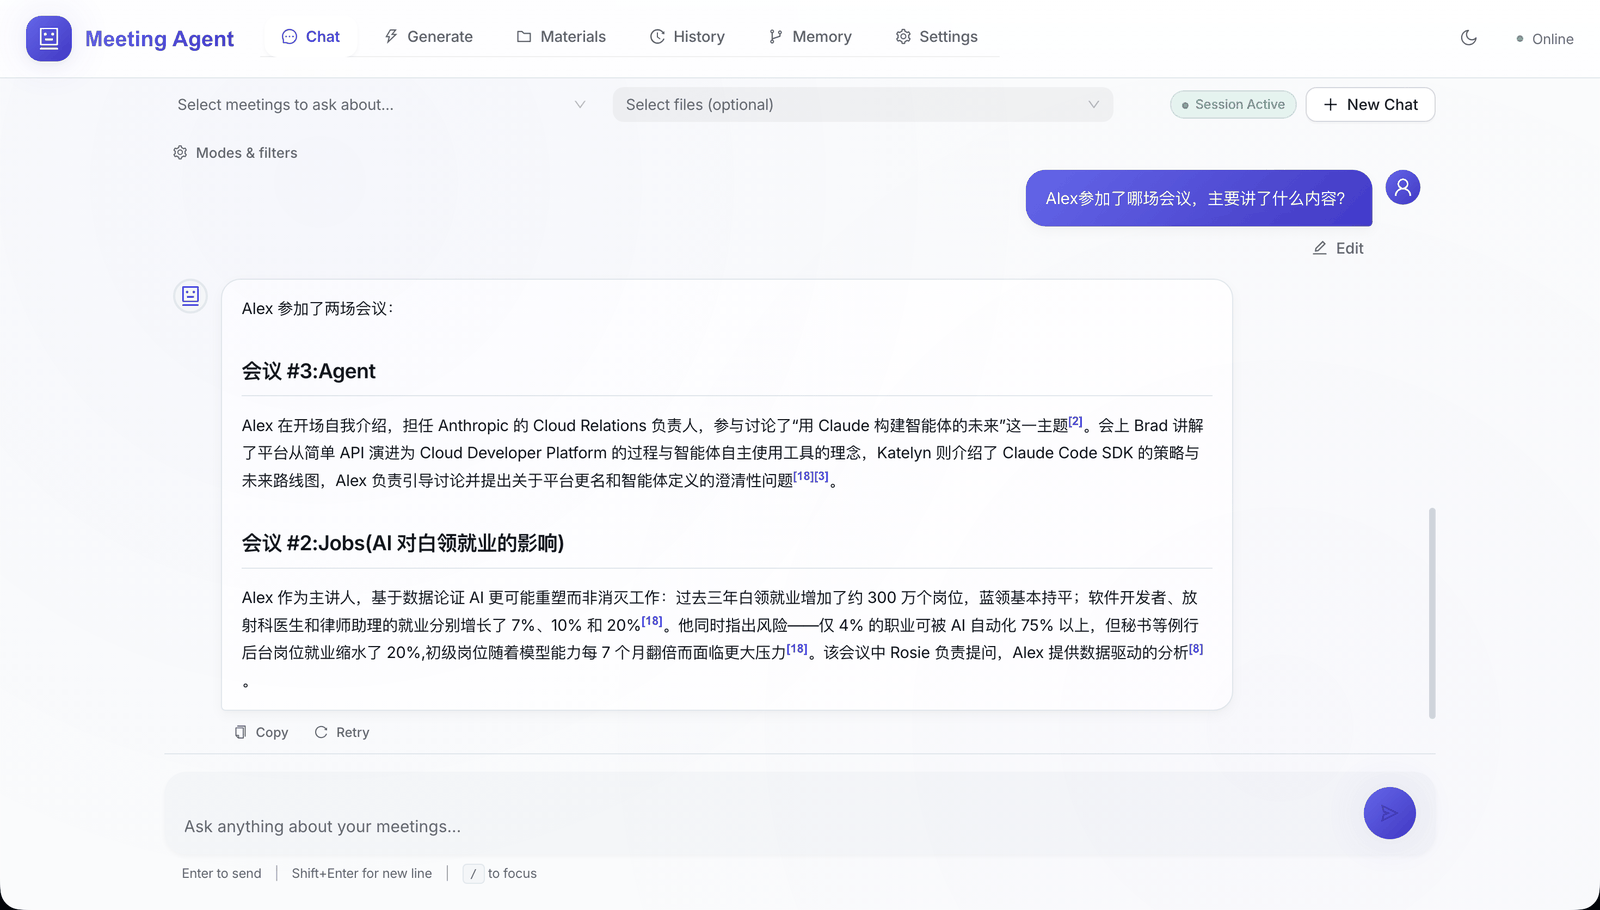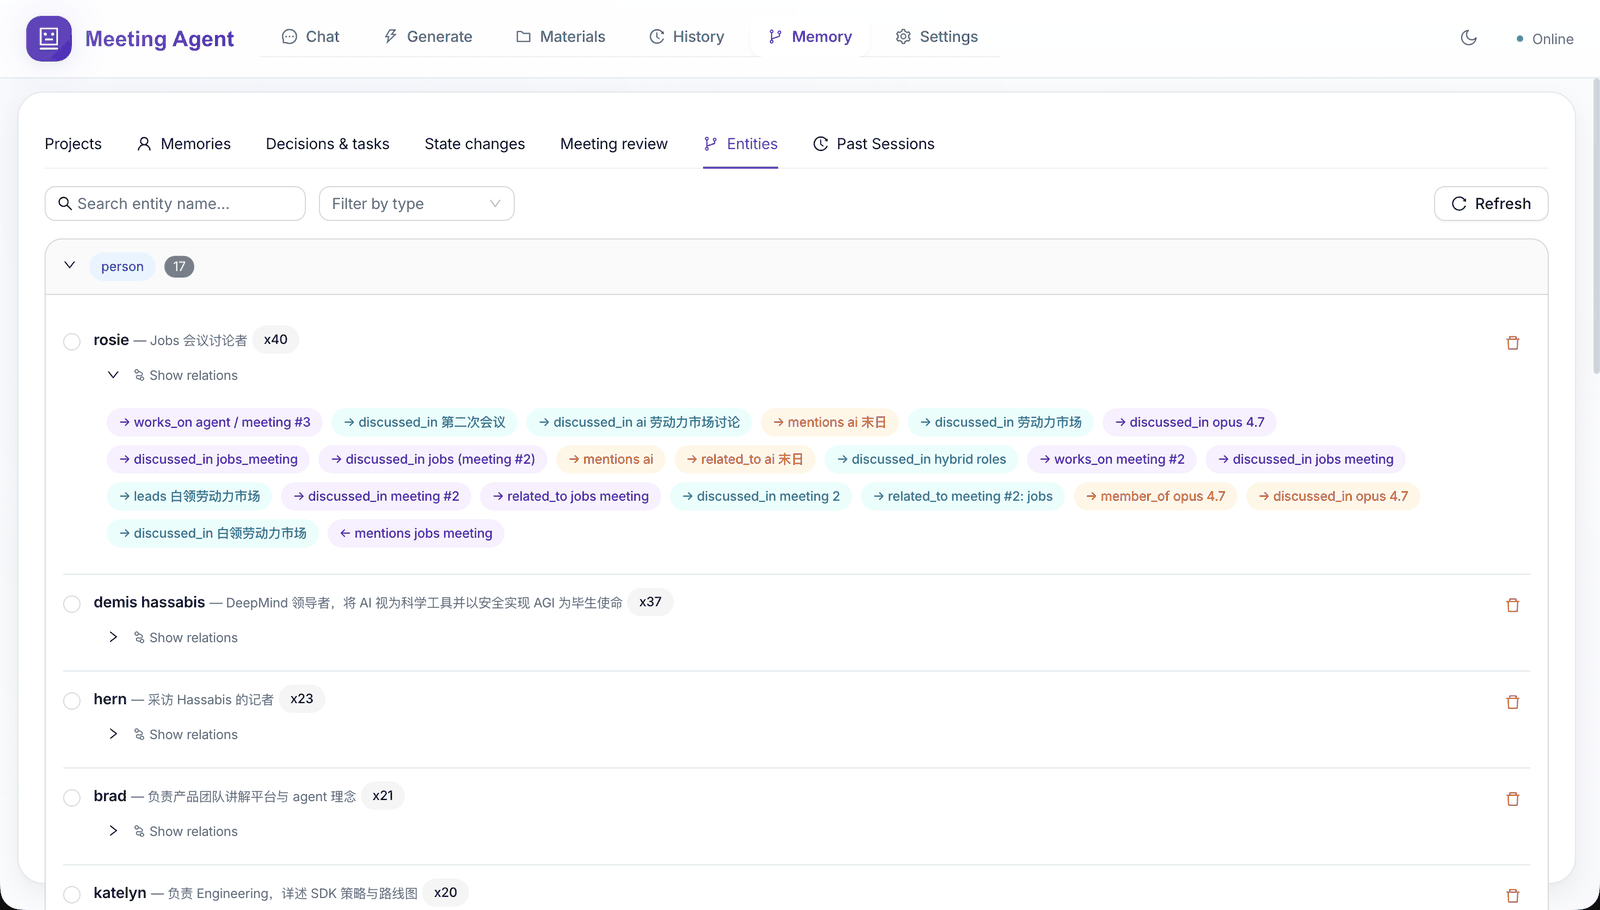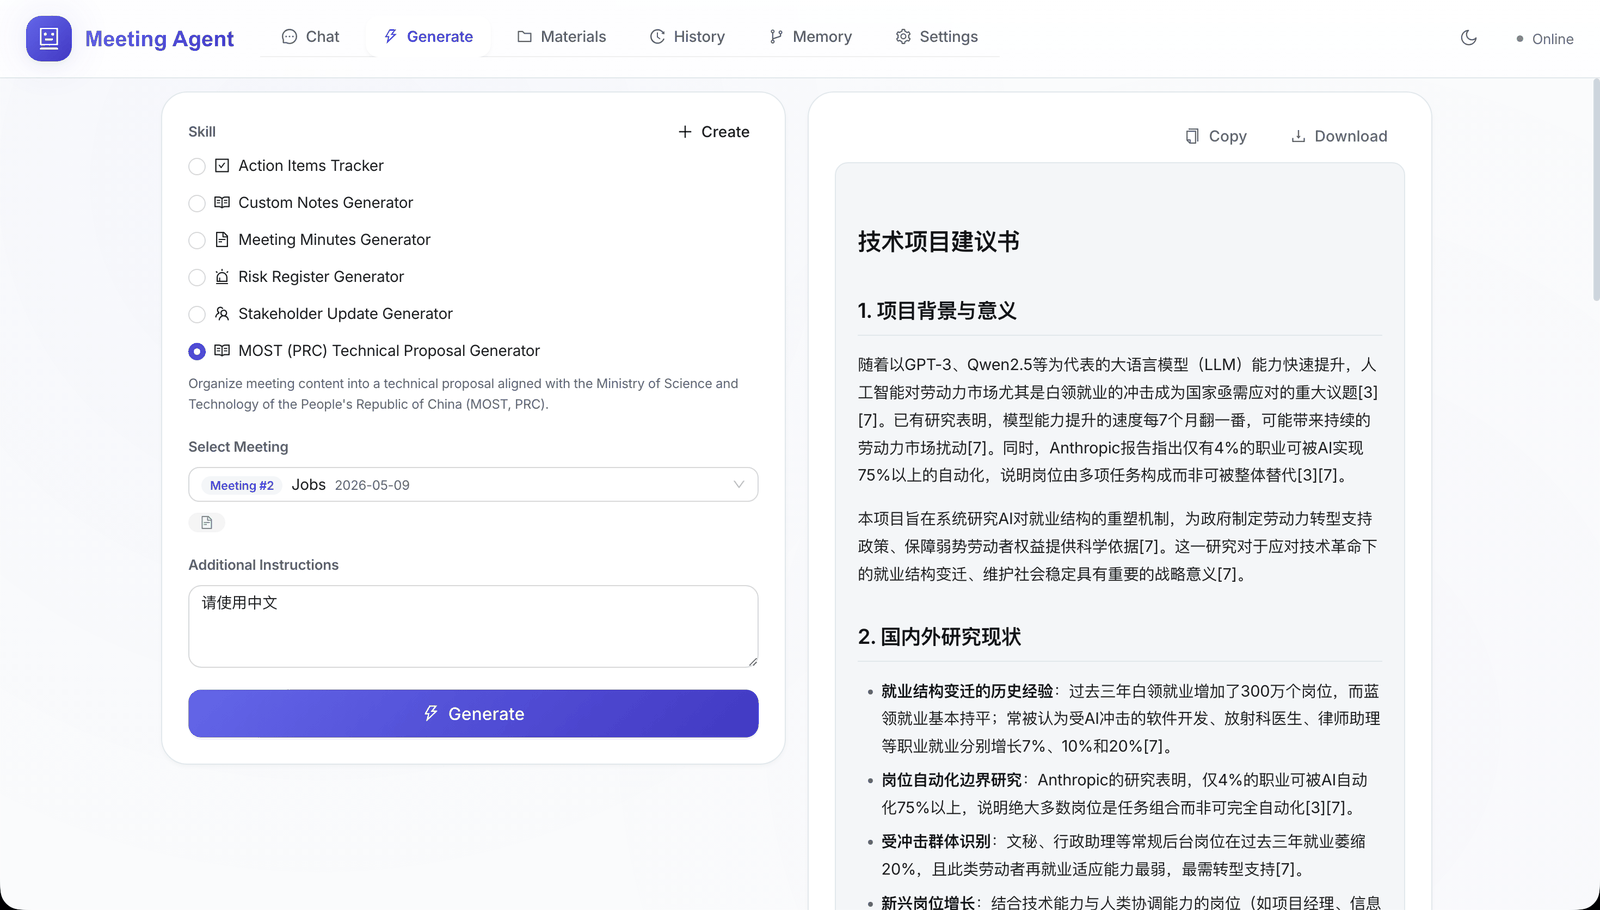
[N] 编号;Chat 界面中的引用均可点击,并跳转到对应来源页、幻灯片或时间戳。/api/v1、按端点限流、使用 AES-GCM 加密响应存储的幂等键、HMAC 签名文件下载令牌,以及结构化 JSON 日志。┌─────────────────────────────────────────────────────────────────┐
│ 前端(React 19) │
│ 聊天 · 素材 · 记忆 · 历史 · 生成 · 设置 │
└──────────────────────────────┬──────────────────────────────────┘
│ /api/v1(经 Vite/nginx 代理)
┌──────────────────────────────▼──────────────────────────────────┐
│ FastAPI · LangChain LCEL │
│ │
│ 上传 → 解析/转录 → 分块 → 嵌入 → Chroma │
│ ↓ │
│ BM25 + FTS5 │
│ │
│ 查询 → 范围路由 → 检索 → 重排 → 上下文 │
│ ↓ │
│ LLM │
│ ↓ │
│ 回答 + 引用 │
│ │
│ 持久任务:摄取 · 摘要 · 事实抽取 · 说话人更新 │
│ Memory:类型化版本 · 证据 · 生命周期 · KG · 衰减 │
└──────────────────────────────────────────────────────────────────┘
后端 —— FastAPI 0.135+ · LangChain LCEL · ChromaDB · SQLite(WAL、Alembic 管理)· slowapi · Pydantic v2。 前端 —— React 19 · TypeScript · Vite 6 · Ant Design 6 · react-router v7 · framer-motion。 基础设施 —— Docker Compose · Helm Chart · Prometheus + Grafana + Loki + Promtail(可选可观测性栈)。
cp backend/.env.example backend/.env
# 编辑 backend/.env:设置 LLM_API_KEY(必需)和 ASSEMBLYAI_API_KEY(处理视频时需要)
make start
make start 会以 restart: unless-stopped 策略在后台启动容器。使用 make status 查看状态,使用 make stop 优雅停止。
Compose 声明的端口映射(宿主机 → 容器):后端 7008 → 8000,前端 8307 → 8080。
如需启用鉴权的 Compose 部署,请将 .env.compose.example 复制为 .env.compose,并设置共享的 API_KEY、PRINCIPAL_PEPPER、CORS_ORIGINS 和非开发模式的 ENVIRONMENT。模型提供商密钥仍存放在 backend/.env;.env.compose 已被 Git 忽略。
ws://localhost:7008/api/v1/ws# 后端(Python 3.12+)
cd backend
uv sync --dev # 推荐;使用 uv.lock 保证可复现安装
# 可选依赖(仅在确实使用对应提供商时安装):
# uv sync --dev --no-group production --extra multimodal # 仅限开发评估;参见 SECURITY.md
# uv sync --dev --extra google # Vertex AI Embedding
# uv sync --dev --extra huggingface # 本地 HF Embedding + BGE 重排器
# uv sync --dev --extra local # huggingface + llama-cpp-python(完全离线)
# uv sync --dev --extra observability # Sentry + OpenTelemetry
cp .env.example .env # 设置 LLM_API_KEY 和 ASSEMBLYAI_API_KEY
uv run python -m uvicorn src.main:app --reload --port 7008 # http://localhost:7008
# 前端(Node 22–24;在另一终端执行;`.node-version` 选择 Node 24)
cd frontend
npm ci
npm run dev # http://localhost:8307,代理 /api → :7008
make dev            # 并行启动后端和前端
make dev-be         # 仅启动后端
make dev-fe         # 仅启动前端
make cli            # 交互式终端前端(scripts.cli_agent)
make lint           # 检查全部代码
make test           # 运行全部测试
make e2e-auth       # 隔离的生产模式 API Key 浏览器检查
make e2e-full-stack # 隔离的真实浏览器验收套件
make qa             # 完整 QA:lint + 测试 + 构建 + 隔离 Playwright E2E
make clean          # 删除生成文件
pip install pre-commit && pre-commit install
.pre-commit-config.yaml 中配置了 ruff、eslint、prettier、bandit、gitleaks 和 detect-secrets。
三级覆盖顺序(越靠后优先级越高):
backend/config/main.yaml —— 非敏感默认值(模型名称、RAG 参数、上传限制)。backend/.env —— 密钥和环境级覆盖。配置通过 pydantic-settings 合并。backend/.env.example 有意只包含凭据和常见覆盖;高级调优请使用 backend/config/main.yaml 或查阅 backend/docs/configuration.md。
backend.replicaCount=1),因为 SQLite 无法安全共享写入。backend.secretName。LLM_MODEL=qwen-plus
LLM_BASE_URL=https://dashscope.aliyuncs.com/compatible-mode/v1
LLM_API_KEY=sk-your-dashscope-key
uv run python -m src.mcp                  # stdio 传输
MCP_TRANSPORT=streamable-http MCP_HTTP_PORT=9000 \
  MCP_API_KEY=replace-me uv run python -m src.mcp  # 回环地址 HTTP
提供的工具:list_meetings、search_meetings、ask_about_meetings、manage_memory、list_skills、invoke_skill。
所有产品 API 路由都使用 /api/v1 版本前缀;Prometheus /metrics 端点有意位于该前缀之外。受保护路由通过 X-API-Key 请求头认证(API_KEY 为空表示开发模式);存活、就绪和基础健康探针有意保持无需认证。限流按端点设置:上传/聊天 20 次/分钟、设置 5 次/分钟、读取 60 次/分钟。错误统一使用 ErrorResponse 包装(code、message、request_id、details)。完整的生成契约导航请参见 backend/docs/api-reference.md;下表是面向产品的精简索引。
/memory 工作区用于审核、组织和复用从对话与会议材料中提取的长期知识。
记录会保留生命周期状态、版本、项目范围和来源证据,而不是被当作未经验证的自由文本模型记忆。
关键治理行为:
桌面端标签栏和窄屏下拉选择器提供相同的七个视图。资料库选择器、筛选器和批量操作均位于页面卡片内部;桌面端仅虚拟化记录区域滚动,窄屏设备使用有边界的响应式列表。交互与布局细节见前端 Memory 工作区文档,抽取、持久化、召回、生命周期和知识图谱机制见记忆与知识图谱文档。
cd backend

uv sync --dev
uv run python -m uvicorn src.main:app --reload         # 开发服务器
uv run python -m src.mcp                               # MCP 服务(stdio)
uv run python -m scripts.cli_agent                     # 交互式 CLI

uv run ruff check src/ tests/                          # lint
uv run ruff format --check src/ tests/                 # 格式检查
uv run pyright                                         # 类型检查

uv run python -m pytest                                # 完整后端测试
uv run python -m pytest tests/chain/                   # 运行一个目录
uv run python -m pytest tests/meetings/test_api.py::TestMeetingsEndpoint::test_upload_unsupported_format
测试标记(定义在 pyproject.toml):unit、integration、benchmark、property、chaos。
测试隔离:conftest.py 会在导入任何应用模块前 monkey-patch constants.DATA_DIR,使测试使用临时数据库,而不会接触生产数据 data/meetings.db。不要在 conftest.py 的模块顶层导入应用模块。
CLI 使用参考:backend/docs/cli.md。
cd frontend

npm install
npm run dev                    # 端口 8307,代理 /api → :7008
npm run build                  # 生产构建
npm run lint                   # eslint
npm run lint:fix
npm run format                 # prettier --write
npm run format:check
npm run type-check             # tsc --noEmit
npm run test                   # vitest watch
npm run test:run               # vitest 单次运行
npm run e2e                    # Playwright(全部浏览器)
npm run e2e:headed             # 有界面的 Chromium
npm run mutation               # Stryker 变异测试
运行单个前端测试:npm run test:run -- src/test/App.test.tsx,或使用 -- -t "renders welcome"。
cd backend

uv run python -m scripts.benchmark chat --iterations 5     # 聊天管线延迟
uv run python -m scripts.benchmark ingest --iterations 3   # 摄取管线
uv run python -m scripts.benchmark micro                   # 组件微基准
uv run python -m scripts.benchmark rag-all                 # 检索 + 回答 + 快照
uv run python -m scripts.benchmark reranker-quality        # 受控重排器对比
uv run python -m scripts.benchmark all --iterations 5 \
  --process-report benchmark-results/e2e-smoke.json        # 全部必需套件
Benchmark 使用临时数据库和 tests/fixtures/benchmark/ 中的合成 fixture,结果写入 benchmark-results/。完整说明参见 backend/docs/benchmarking.md。
下表是唯一的当前得分摘要,生成相关套件的最新验证完成于 2026-09-09 17:39 UTC。机器可读结果、报告哈希、模型角色与限制记录在 docs/validation/latest-benchmark.json 中。
Chat、RAG Answer、Multi-turn 和 E2E 已在移除错误的 2.5 秒硬生成截断后重新运行;不受影响的套件保留各自最近一次结果。因此,下表是“各套件最新结果”的汇总,而不是同一时刻完成的一次原子化全套运行。
验证时的模型角色分别是:z-ai/glm-5.3-flash 用于主生成,qwen/qwen3.8-flash 用于独立评审,deepseek/deepseek-v4-flash-vision-exp 用于 Memory 抽取和视觉任务。这些是面向本项目合成数据的诊断,不是仓库默认配置,也不是通用模型排名。OpenRouter 提供商端点没有固定到特定后端。由于两个 Chat 性能门控均未通过、公开质量集规模较小且为合成数据、多轮对话仅进行一次评审、视觉仅使用一张截图,并且运行中观察到提供商 504 及查询改写/指代消解超时,系统目前仍然未达到发布就绪状态。
一条命令启动监控栈:
export GRAFANA_ADMIN_PASSWORD="$(openssl rand -hex 24)"
docker compose -f docker-compose.yaml -f docker-compose.observability.yaml up
/metrics 端点。data/logs/ 采集文件,无需暴露 Docker Socket。monitoring/prometheus/alerts.yaml)覆盖请求延迟、错误率、断路器触发和磁盘使用率。发布由 Git Tag 触发:
git tag v0.2.0
git push origin v0.2.0
.github/workflows/release.yml 会构建多架构后端/前端镜像并推送到 GHCR,执行冒烟测试和全栈 E2E、验证 Helm Chart、通过 git-cliff 生成 Changelog,并创建 GitHub Release。手动恢复 Action 只能提升已经发布的容器镜像;它要求明确的“仅二进制”确认,以及同一仓库中带 data-recovery-approved 标签的 GitHub Issue;它不会降级或恢复 SQLite、上传文件或 Chroma。
镜像发布还会以失败关闭方式检查:docs/validation/release-readiness.json 必须存在、来源于干净运行、匹配当前数据集/测试框架/实现指纹,并明确记录生产质量、人工业务审核、性能 SLO 和安全门控均已通过。
每个门控都必须通过路径和 SHA-256 引用仓库中的常规 JSON 资产。资产必须未过期、注明审核人、绑定同一组实现指纹,并包含 docs/validation/release-evidence-artifact.template.json 中所示的门控完成字段。随后工作流会在提升前校验候选镜像的精确 Digest。请从 docs/validation/release-readiness.template.json 开始;历史验证文件不能满足该门控。
候选镜像冒烟测试会在启用生产验证的情况下启动后端,并使用与质量工作流相同的受保护提供商配置。发布前请配置以下仓库 Actions Secrets:QUALITY_LLM_API_KEY、QUALITY_LLM_BASE_URL、QUALITY_LLM_MODEL、QUALITY_EMBEDDING_API_KEY、QUALITY_EMBEDDING_BASE_URL 和 QUALITY_EMBEDDING_MODEL。任何值缺失都会在镜像提升前终止候选任务。
backend/docs/operations/slo.mdbackend/docs/operations/sla.mdbackend/docs/operations/backup.md、backend/docs/operations/restore.mdbackend/docs/operations/retention.mdbackend/docs/operations/alembic.mdbackend/docs/operations/runbooks/A full-stack multimodal meeting intelligence system with layered RAG, long-term memory, and skill-based generation.
工具
尚無工具清單。遠端伺服器會在首次健康檢查後取得工具清單。
常見問題
在本頁複製適用於 Cursor、Claude Desktop、Claude Code 或 VS Code 的 stdio 設定。它使用發布者的安裝方式,而不是 PlugMCP 代理伺服器。
這筆記錄未列出必要的環境變數。
Meeting Agent 透過 stdio 在本機執行。
上次檢查時間:2026-10-28。 A full-stack multimodal meeting intelligence system with layered RAG, long-term memory, and skill-based generation.
