Backend de agente LLM multi-provider para atendimento digital. Roteia requisições entre OpenAI, OpenRouter e Ollama; executa toolpacks Python; recupera contexto de uma base de conhecimento vetorial (RAG); transmite respostas via SSE; e expõe o conjunto completo de ferramentas por um servidor MCP opcional.
Sumário
Multi-provider LLM agent backend with RAG, Python toolpacks, SSE streaming and MCP server. Supports OpenAI, OpenRouter and Ollama with per-session routing, tool-calling loop and OpenTelemetry observability.
OpenAI, OpenRouter, Ollama: lista de prioridade, fixação de sessão, balanceamento de carga
Despacho por capacidade
Cada provider declara text, image, audio, embedder; requisições são roteadas para um provider capaz
Loop de tool-calling
Loop iterativo do agente com limite configurável de iterações; suporta function-calling nativo e fallback JSON
Toolpacks Python
Ferramentas de negócio definidas como manifest.json + main.py; carregadas no startup, sem recompilação Go
Pool persistente de workers Python
Subprocessos Python reutilizáveis (protocolo JSON-Lines) substituem a criação de processo por chamada
RAG com score de relevância
Recuperação híbrida (densa + esparsa) do Qdrant; cada trecho injetado exibe [relevance: X.XX]; reranking por cross-encoder opcional
Ingestão dinâmica de conhecimento
POST /knowledge/ingest aceita texto JSON ou upload de arquivo (.md, .txt, .csv); fragmenta, valida dimensão de embedding e indexa no Qdrant sem reiniciar
Streaming SSE
Streaming token a token com eventos tool_start/tool_end e frame final de resumo
Servidor MCP
Servidor Model Context Protocol opcional expondo o mesmo conjunto de toolpacks
Retry com backoff
Erros transitórios de provider (429, 503, rate-limit) são reprocessados com backoff exponencial
Monitoramento de saúde do provider
Contadores de erro por provider expostos em /health; probes /health/live e /health/ready para Kubernetes
Cache de resposta e embedding
Caches LRU em memória com TTL configurável
Cache de compressão de histórico
Histórico de conversa comprimido indexado por sessão + comprimento; evita contagem redundante de tokens
Deduplicação singleflight
Requisições concorrentes idênticas (mesma sessão + mesmo input) compartilham uma única chamada de inferência
Middleware CORS configurável; rate limiter por IP com token-bucket
Watch de configuração
Flag --watch-config recarrega o arquivo de configuração sem reiniciar o processo
Arquitetura
cmd/api/
  main.go                   Bootstrap: config, logger, telemetria, HTTP, MCP, graceful shutdown
  agent.go                  Registro de adapters LLM e construção do Agent
  http.go                   Router Gin; middlewares (CORS, rate limit, request-ID, logging)
  mcp.go                    Inicialização do servidor MCP com auth Bearer opcional
  rag.go                    Inicialização do RAG engine (Qdrant + embedder)
  ratelimit.go              Rate limiter por IP (token-bucket)
  telemetry.go              Inicialização do OpenTelemetry (traces + métricas)

internal/
  agent/
    agent.go                Struct Agent; singleflight; saúde do provider; cache de capacidades
    run.go                  Loop de provider; retry com backoff exponencial; inferência
    routing.go              Seleção de provider; filtro de capacidade (cacheado); balanceamento
    context_manager.go      Compressão de histórico; cache de template (SHA-1); orçamento de tokens
    message_builder.go      Montagem de mensagens; RAG com score; compressão cacheada por sessão
    knowledge_ingestor.go   Ingestão dinâmica de texto no Qdrant; validação de dimensão de embedding
    tool_caller.go          Struct ToolCaller; loop Execute; métodos de configuração
    tool_caller_native.go   Passo de function-call nativo
    tool_caller_fallback.go Passo de fallback JSON; recuperação de tool-call a partir de texto puro
    tool_caller_exec.go     Execução de tool; validação de argumentos; log de campos ausentes
    tool_caller_format.go   Prompts de schema; contexto de roteamento; limpeza de texto
    constants.go            Constantes nomeadas para todos os limites e atrasos padrão
    document_identifier.go  Classificação de tipo de documento via LLM
    media.go / audio.go     Processamento de anexos multimodais

  config/              Leitura e normalização da configuração (YAML, TOML, JSON)
  handlers/            Handlers HTTP; payload de saúde; ingestão de conhecimento
  streaming/           Streamer SSE; eventos tool_start/tool_end durante execução
  tools/               Descoberta de toolpacks, validação de manifestos, runtime Python
    pool.go            Pool persistente de workers Python (ProcessPool)
    runtime_python.go  Execução pool-first com fallback para subprocesso legado
  knowledge/           Carregamento da base de conhecimento, chunking, indexação RAG
  openai/              Adapter do provider OpenAI (compatível com API OpenAI)
  openrouter/          Adapter do provider OpenRouter
  ollama/              Adapter do provider Ollama
  port/                Contratos de interface (ConfigProvider, LLMProviderConfig, …)
  shared/              Helpers compartilhados entre providers

pkg/
  telemetry/           Inicialização OpenTelemetry e métricas HTTP
  oauth2tkm/           Gerenciador de token OAuth2
  viper/               Wrapper Viper para leitura de configuração

examples/
  tools/               Toolpacks de exemplo: caso de uso pizzaria
    create_order/        manifest.json + main.py
    finish/
    get_menu/
    get_order_status/
    runtime.py           Helpers de runtime compartilhados
    _pool_worker.py      Worker persistente (protocolo JSON-Lines)
  knowledge/           Base de conhecimento de exemplo: pizzaria
    kb_pizzaria/         Arquivos Markdown com cardápio, fluxo, pagamentos, etc.
    knowledge.json       Índice de chunks para o RAG
Ciclo de Vida de uma Requisição
Cliente
  │  POST /chat ou /chat/stream
  ▼
Handler HTTP (rate limit → CORS → request-ID → logging)
  │  valida → constrói agent.Request
  ▼
Agent.Run (singleflight na chave sessão+input)
  │  buildMessages: system prompt + histórico comprimido + contexto RAG
  ▼
Seleção de provider (filtro de capacidade → prioridade → balanceador)
  │  loop de retry: attemptInference → retryWithBackoff(maxRetries=2, baseDelay=500ms)
  ▼
Inferência LLM (OpenAI / OpenRouter / Ollama)
  │  tool-call nativo OU tool-call fallback JSON
  ▼
Execução de tool (loop ToolCaller.Execute, máx 6 iterações)
  │  Go despacha para pool de workers Python → _pool_worker.py executa main.py
  ▼
Montagem da resposta → stream SSE / resposta JSON
  │  recordProviderHealth
  ▼
Cliente
Pré-requisitos
Go1.22+
Python3.x disponível como python3 (ou defina TOOLPACKS_PYTHON_BIN)
Qdrant acessível se rag.enabled = true
Ollama em execução se usado como provider ou embedder
Um arquivo de configuração válido em configs/ (suporta YAML, TOML ou JSON; o formato é detectado automaticamente pela extensão do arquivo)
Início Rápido
# 1. Copie o config de exemplo e preencha suas chaves / caminhos
cp configs/config.example.yml configs/config.yml

# 2. (Opcional) Suba a stack de desenvolvimento: Qdrant, Jaeger, Prometheus, Grafana
docker compose -f .devcontainer/docker-compose.dev.yml up -d

# 3. Execute o agente
go run ./cmd/api -config ./configs/config.yml

# 4. (Opcional) Habilite o watch automático do arquivo de configuração
go run ./cmd/api -config ./configs/config.yml --watch-config
Flags disponíveis:
Flag
Padrão
Descrição
-config
config.yaml
Caminho para o arquivo de configuração (YAML, TOML ou JSON)
--watch-config
false
Recarrega o config automaticamente ao detectar alterações no arquivo
Variáveis de ambiente:
Variável
Finalidade
TOOLPACKS_PYTHON_BIN
Sobrescreve o caminho do binário Python (padrão: python3)
Makefile
make build     # Constrói a imagem Docker (usa IMAGE_NAME e VERSION)
make deploy    # Publica e executa via scripts/sh/deploy.sh
make test      # Executa a suíte de testes com detector de corrida
make swagger   # Gera documentação Swagger
make profiler  # Inicia o profiler de CPU/memória
Variáveis Makefile:
Variável
Padrão
Descrição
IMAGE_NAME
nexus_agent
Nome da imagem Docker
VERSION
1.0.0
Tag de versão da imagem
Stack de Desenvolvimento
O docker-compose.dev.yml sobe:
Serviço
URL padrão
Agent API
http://localhost:3000
Exportador de métricas Prometheus
http://localhost:9464/metrics
UI Prometheus
http://localhost:9091
UI Grafana
http://localhost:3001
UI Jaeger
http://localhost:16686
Qdrant
http://localhost:6333
Referência de Configuração
O arquivo de configuração único fica em configs/ e é passado via flag -config. A aplicação suporta os formatos YAML (.yml/.yaml), TOML (.toml) e JSON (.json) o formato é detectado automaticamente pela extensão do arquivo. Todos os caminhos relativos dentro do arquivo são resolvidos a partir do diretório de trabalho no startup.
Nível raiz
env: "dev"          # dev | prod
log_level: "debug"  # debug | info | warn | error
[server]
port            = 3000
read_timeout    = "30s"
write_timeout   = "30s"    # deve ser >= request_timeout
idle_timeout    = "60s"
request_timeout = "120s"
[llm_providers.<nome>]
Cada seção de provider compartilha um conjunto comum de campos:
[llm_providers.ollama]
base_url             = "http://127.0.0.1:11434"
model                = "qwen3:4b"
embedding_model      = "mxbai-embed-large:335m"
system_prompt        = "./prompts/system.txt"
schema_template      = "./schemas/ollama_schema.json"
tool_prompt          = "./prompts/tool.txt"           # instrução de tool-call injetada no system prompt
tool_router_prompt   = "./prompts/tool_router.txt"    # usado ao rotear para a tool correta
document_identifier_prompt = "./prompts/doc_id.txt"
user_prompt_prefix   = ""
native_tool_caller   = true     # usa a API de function-calling nativa do provider
temperature          = 0.35
max_tokens           = 768
num_ctx              = 4096     # janela de contexto específica do Ollama
num_predict          = 768      # limite de tokens específico do Ollama
top_k                = 20
top_p                = 0.9
repeat_penalty       = 1.12
capabilities         = ["text", "embedder"]

[llm_providers.openai]
api_key              = "<OPENAI_API_KEY>"
base_url             = "https://api.openai.com/v1"
model                = "gpt-4o-mini"
temperature          = 0.6
max_tokens           = 1024
system_prompt        = "./prompts/system.txt"
native_tool_caller   = false
capabilities         = ["text", "audio", "image"]

[llm_providers.openrouter]
api_key              = "<OPENROUTER_API_KEY>"
base_url             = "https://openrouter.ai/api/v1"
site_url             = "https://seu-site.exemplo"
app_name             = "nexus-agent"
model                = "openai/gpt-4o-mini"
temperature          = 0.6
max_tokens           = 1024
system_prompt        = "./prompts/system.txt"
native_tool_caller   = false
capabilities         = ["text", "audio", "image"]
Capacidades:
Valor
Significado
text
Geração de texto geral
image
Visão / análise de imagem
audio
Transcrição de fala / áudio
embedder
Geração de embeddings (obrigatório para RAG)
[llm_routing]
[llm_routing]
priority          = ["openrouter", "openai", "ollama"]   # preferência decrescente
default_embedder  = "ollama"   # provider usado para embeddings do RAG
pinning_session   = true       # fixa cada sessão no primeiro provider que respondeu com sucesso

[llm_routing.load_balancing]
enabled  = false
mode     = "both"     # request | session | both
timeout  = "10s"      # troca de provider após este tempo sem resposta
sessions = 1000       # máximo de sessões por provider
Regras:
pinning_session = true: uma vez que uma sessão escolhe um provider, ela permanece nele.
load_balancing.timeout deve ser menor que server.request_timeout quando o balanceamento está ativo.
[context]
max_context_tokens = 3000   # orçamento de tokens para o histórico comprimido injetado no prompt
max_history_turns  = 4      # turnos de conversa mantidos antes da compressão
max_tool_iter      = 6      # máximo de iterações de tool-calling por requisição
A base de conhecimento é um arquivo JSON apontado por rag.knowledge_path. Cada entrada descreve um chunk de conhecimento:
[
  {
    "id": "kb_000",
    "category": "assistant_persona",
    "files_path": "./knowledge/persona",
    "role": "system"
  },
  {
    "id": "kb_001",
    "category": "rules",
    "content": "Forneça previsões apenas com base nos dados retornados pela tool de clima.",
    "role": "system"
  },
  {
    "id": "kb_002",
    "category": "faq",
    "files_path": "./knowledge/faq",
    "role": "user"
  }
]
Campos:
Campo
Descrição
id
Identificador único
category
Rótulo do grupo lógico
content
Conteúdo de texto inline
files
Lista de caminhos de arquivo a carregar
files_path
Diretório; todos os arquivos suportados dentro são carregados
role
system ou user (ausente = user)
Comportamento do role:
system: carregado uma vez no startup e anexado ao system prompt como contexto fixo.
user: fragmentado, embedado e indexado no Qdrant; recuperado dinamicamente por requisição com base em similaridade semântica.
Extensões de arquivo aceitas para chunking:.md, .markdown, .txt, .csv
rag.knowledge_path é opcional. Se estiver vazio ou ausente, o agente inicializa sem conhecimento estático e a coleção Qdrant é criada vazia. O endpoint POST /knowledge/ingest pode ser usado para popular o índice em runtime.
Chunking e Overlap de Sentenças
Textos longos são divididos em chunks de tamanho controlado. Quando um parágrafo é quebrado em múltiplos chunks de sentenças, a última sentença do chunk anterior é repetida no início do próximo (defSentenceOverlap = 1). Isso preserva continuidade semântica entre chunks adjacentes, melhorando a qualidade da recuperação RAG.
Score de Relevância no Contexto
Quando rag.enabled = true e um store vetorial está configurado, o agente busca documentos via SimilaritySearch e prefixa cada trecho recuperado com seu score de similaridade:
[relevance: 0.87] Consultas de segunda a sexta das 08h às 18h.
[relevance: 0.74] Agendamentos podem ser feitos pelo app ou presencialmente.
Trechos com score abaixo de rag.min_score são descartados. Se nenhum trecho passar pelo filtro e rag.force_always = true, a busca é repetida sem threshold de score.
Ingestão Dinâmica de Conhecimento
O endpoint POST /knowledge/ingest indexa conteúdo diretamente no Qdrant em runtime, sem necessidade de reiniciar o agente. Aceita dois formatos:
application/json: campo text com o conteúdo em texto plano
multipart/form-data: campo file com upload de arquivo (.md, .txt, .markdown, .csv; limite 10 MB)
Em ambos os casos o conteúdo é fragmentado com a mesma lógica da carga estática (overlap de sentenças para texto, agrupamento de linhas para CSV). Antes da indexação, a dimensão do embedding é validada contra o tamanho esperado, evitando inconsistências na coleção Qdrant.
Modelo de Execução de Ferramentas
Estrutura do Toolpack Python
<toolpacks_dir>/
  _pool_worker.py         Processo worker persistente (gerenciado pelo Go)
  runtime.py              Helpers de runtime compartilhados (opcional)
  <tool>/
    manifest.json
    main.py
    .env.example          Variáveis de ambiente esperadas pela tool
Em vez de criar um novo processo Python a cada chamada de tool, o Go mantém um pool de processos _pool_worker.py persistentes (tamanho padrão = min(NumCPU, 8)).
Cada worker serializa chamadas com um mutex. Se um worker morrer, é substituído de forma transparente antes da próxima requisição. Se o pool estiver indisponível, o agente faz fallback para o subprocesso legado por chamada.
Modos de Tool-Call
Tool-calling nativo (native_tool_caller = true): a API de function-calling do provider é utilizada. Chamadas de tool estruturadas chegam em ContentChoice.ToolCalls.
Fallback JSON (native_tool_caller = false): o agente injeta um prompt de schema na mensagem de sistema. O modelo responde com um envelope JSON que o agente analisa e despacha:
Monta o prompt completo (system + histórico comprimido + contexto RAG + mensagem atual).
Chama o LLM.
Analisa a resposta em busca de uma tool call (nativo ou fallback JSON).
Executa a tool via pool de workers.
Anexa a mensagem do assistente + resultado da tool ao histórico de trabalho.
Repete a partir do passo 2, até context.max_tool_iter (padrão 6) iterações.
Retorna a resposta textual final.
Retry com Backoff Exponencial
Erros transitórios de providers: HTTP 429, 503, 502, mensagens contendo rate limit, overloaded ou too many requests acionam até 2 retentativas com backoff exponencial a partir de 500 ms (delay = 500ms × 2^tentativa).
Toolpacks de Exemplo (pizzaria)
Toolpack
Descrição
create_order
Registra um novo pedido
finish
Sinaliza o encerramento da conversa
get_menu
Retorna o cardápio disponível
get_order_status
Consulta o status de um pedido existente
API HTTP
POST /chat
Chat síncrono: aguarda a resposta completa do agente.
Requisição:
{
  "history": [
    {
      "input":  "{\"protocol\":\"site\",\"name\":\"Ana\"}",
      "output": "Olá! Sou a Nina, sua assistente de atendimento."
    }
  ],
  "text": "Qual é a previsão do tempo para Belém/PA?",
  "media": {
    "type": "image",
    "data": "<base64>",
    "mime_type": "image/jpeg"
  }
}
Probe de liveness confirma que o processo está em execução. Não avalia o estado dos providers. Retorna sempre 200 enquanto o processo estiver vivo.
{"status": "ok"}
GET /health/ready
Probe de readiness indica se o agente está apto a servir requisições. Retorna 503 quando todos os providers configurados foram tentados e nenhum completou uma requisição com sucesso.
Resposta 200 (pronto):
{"status": "ok"}
Resposta 503 (degradado):
{"status": "degraded", "reason": "all LLM providers are failing"}
Um provider com zero requisições é tratado como saudável (estado desconhecido). O 503 só é emitido quando todos os providers foram efetivamente tentados e falharam em 100% das tentativas.
GET /metrics
Retorna um snapshot JSON de métricas de runtime para troubleshooting operacional (contagens de requisição, histogramas de latência, uso de tools, taxas de cache hit, etc.).
Integração MCP
Quando mcp.enabled = true, o agente inicia um servidor Model Context Protocol em mcp.addr (padrão :8090). O mesmo conjunto de toolpacks carregado no startup é exposto para qualquer cliente MCP compatível. Os schemas das tools são derivados diretamente dos arquivos manifest.json.
Se mcp.token estiver preenchido, o servidor exige autenticação Bearer no header Authorization. Requisições sem token ou com token incorreto são rejeitadas com 401.
Observabilidade
Traces
Traces distribuídos são exportados via OTLP/gRPC para o endpoint configurado em telemetry.otlp_endpoint. Cada requisição HTTP, chamada LLM, execução de tool e recuperação RAG é instrumentada com spans.
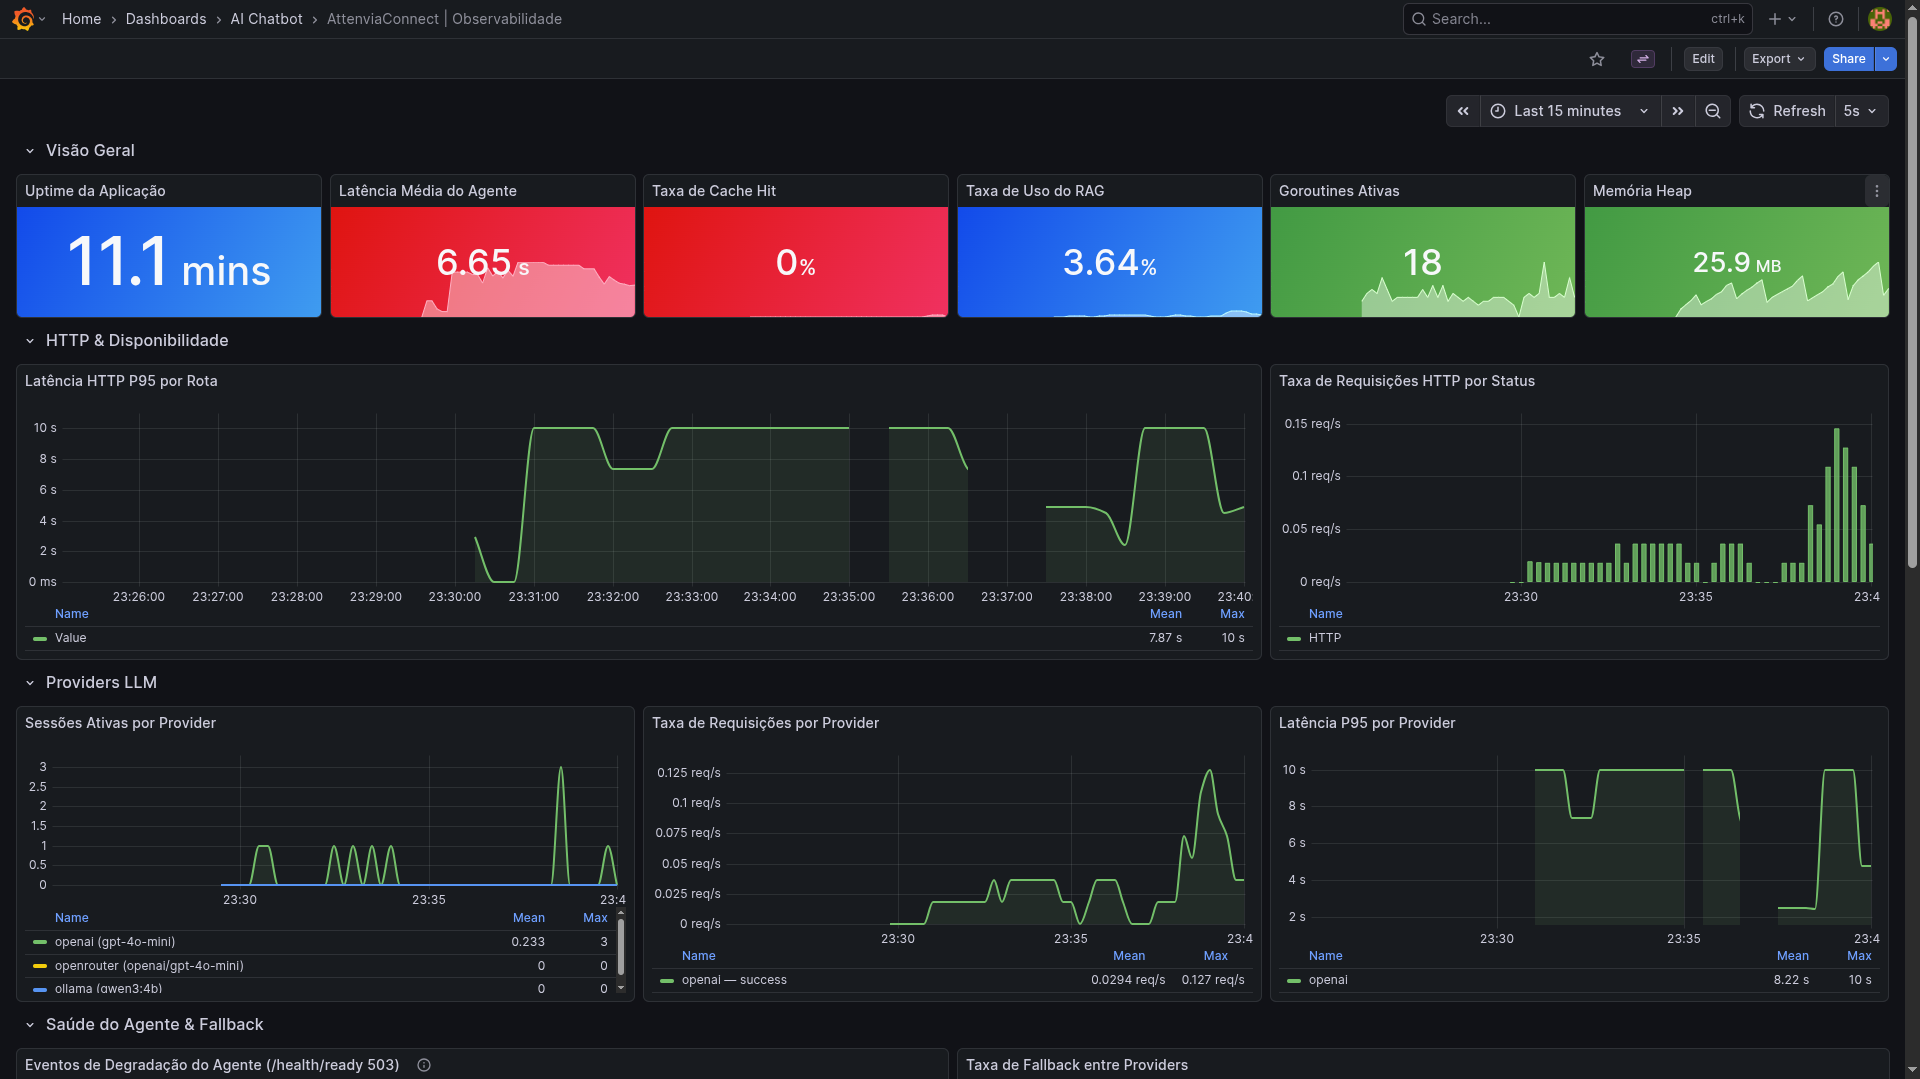
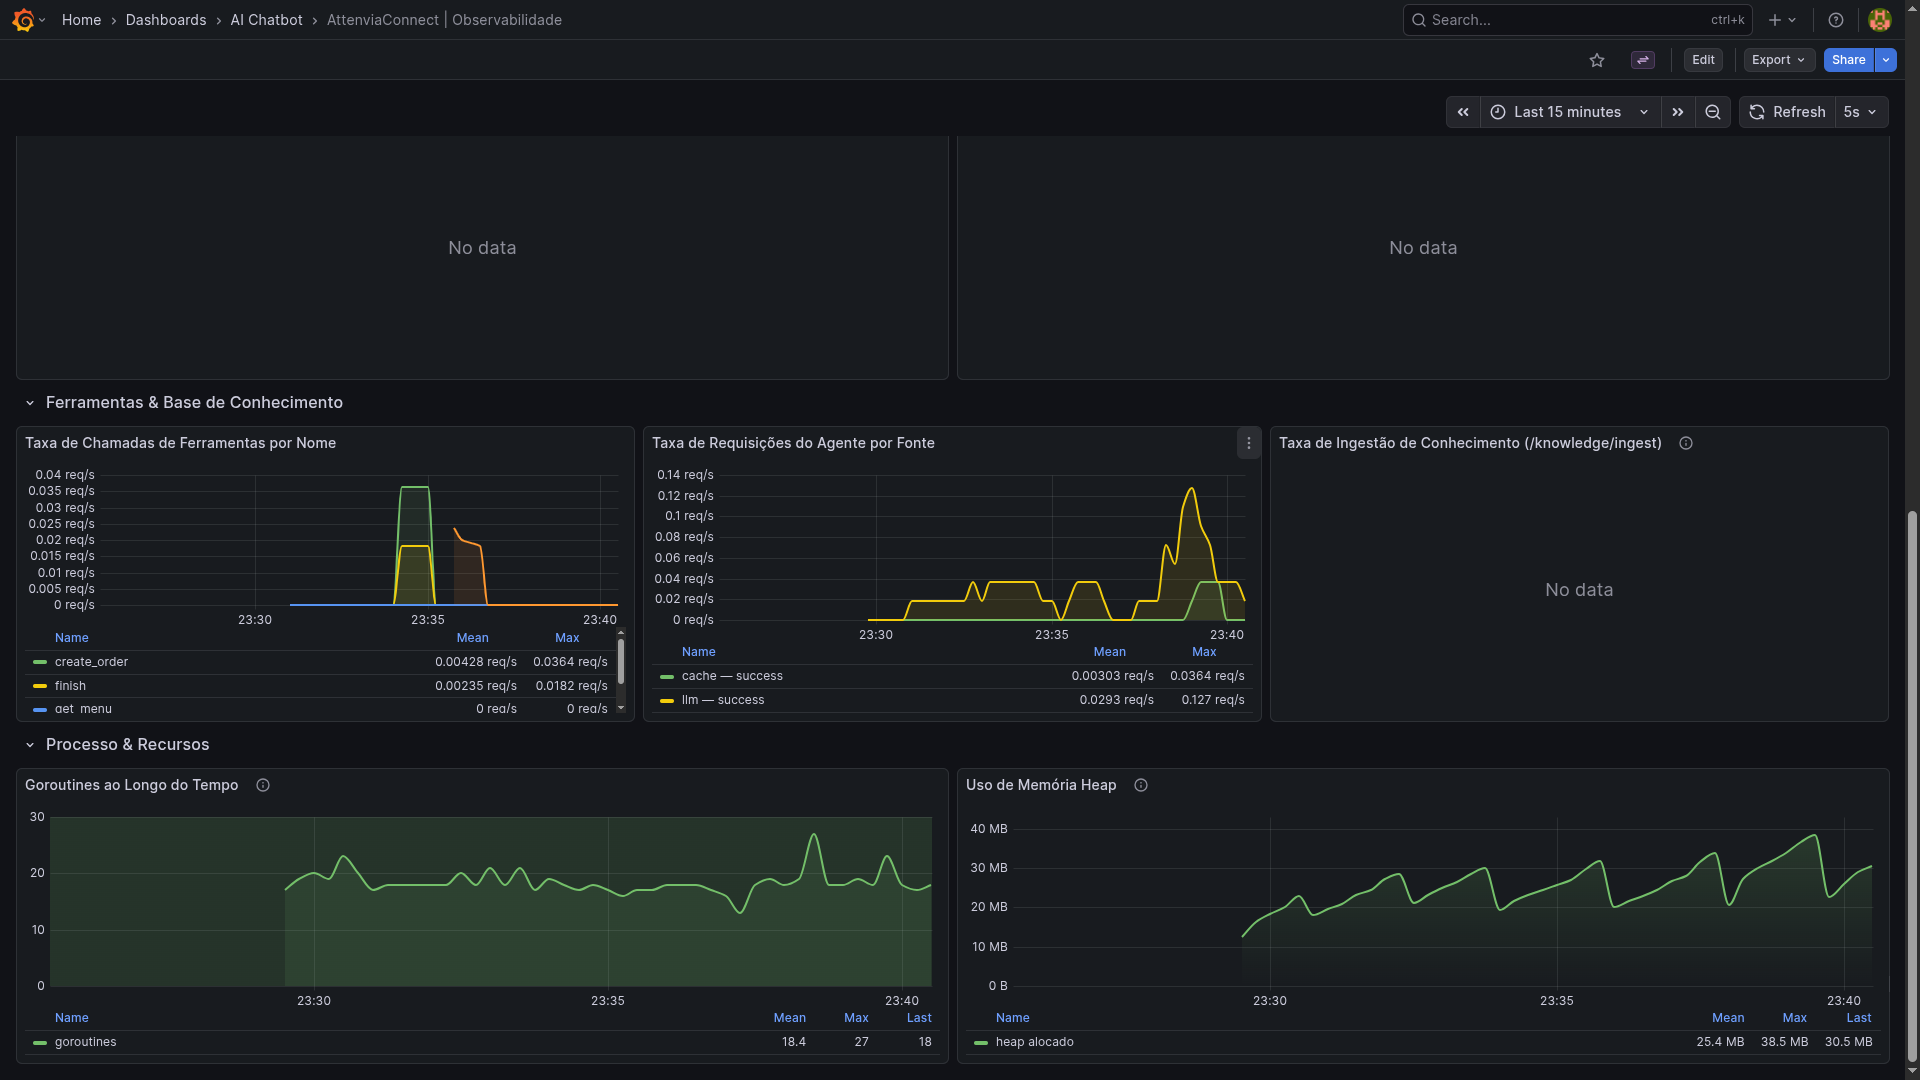
Métricas
Métricas Prometheus são expostas em telemetry.metrics_host:telemetry.metrics_port/telemetry.metrics_path.
Categorias de métricas:
Contagem, latência e erros de requisições HTTP
Contagem, latência e uso de tokens de inferência LLM
Contagem, latência e erros de execução de tools (por nome de tool)
Taxas de cache hit/miss (resposta e embedding)
Contagens de fallback de provider e sessões ativas por provider
Contagem e latência de recuperação RAG e ingestão de conhecimento
Métricas de runtime Go (goroutines, heap)
Os dashboards Grafana pré-configurados ficam em .docker/grafana/dashboards/ e são provisionados automaticamente ao subir a stack de desenvolvimento.
Logs
Logs JSON estruturados no log_level configurado. Tracebacks Python dos subprocessos são automaticamente encaminhados para o stderr do processo Go pelo pool de workers.
Exemplos Incluídos
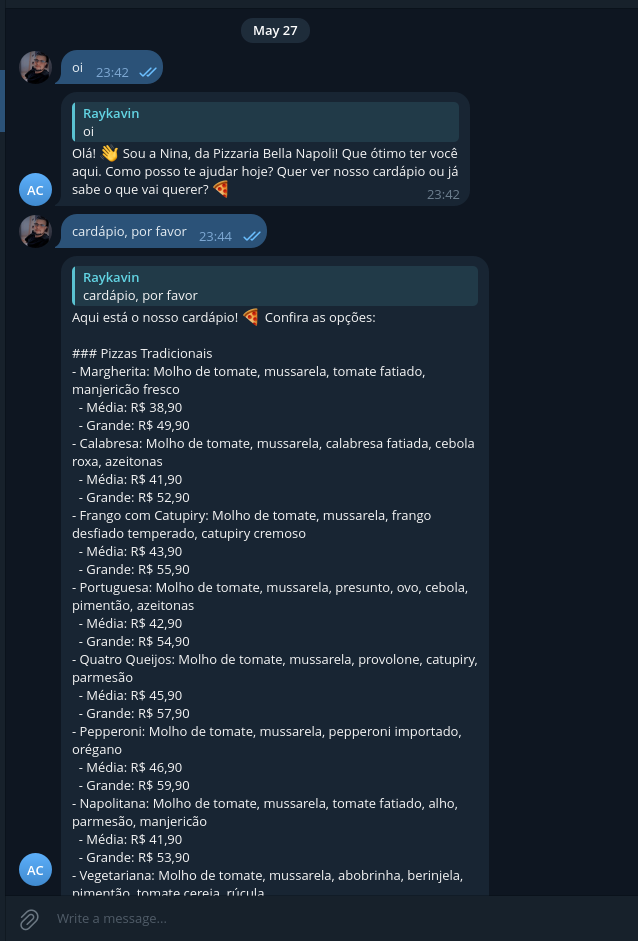
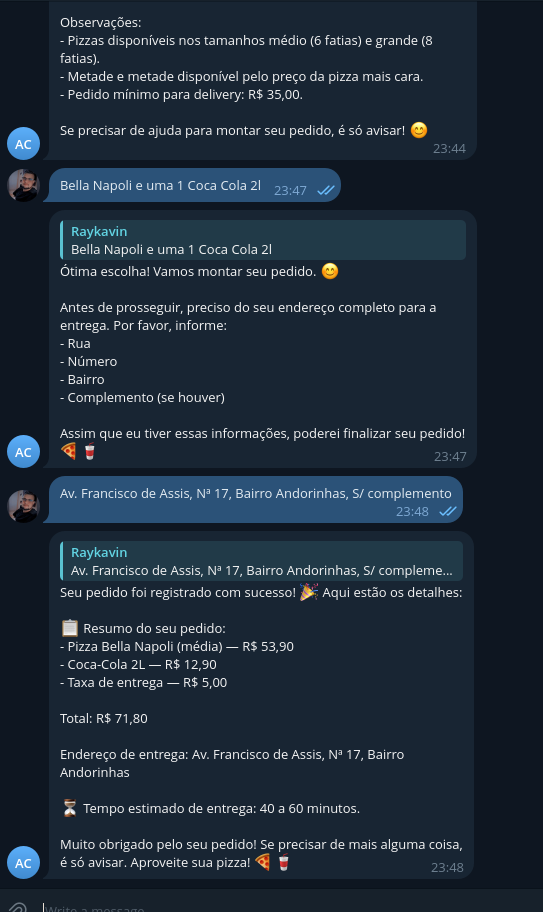
O diretório examples/ contém um caso de uso completo: Pizzaria Bella Napoli que pode ser usado como ponto de partida para novos domínios.
Estrutura
examples/
  tools/
    create_order/     Registra pedidos (grava em arquivo local)
    finish/           Encerra a conversa
    get_menu/         Retorna cardápio com preços
    get_order_status/ Consulta status de pedido por ID
    runtime.py        Helpers compartilhados entre tools
    _pool_worker.py   Worker persistente
  knowledge/
    kb_pizzaria/
      01_cardapio.md
      02_fluxo_pedido.md
      03_pagamentos.md
      04_informacoes_fixas.md
      05_promocoes.md
    knowledge.json    Índice de chunks para o RAG
Playground
O diretório playground/ contém integrações prontas para testar o agente em plataformas de mensageria:
Integração
Localização
Descrição
Telegram
playground/telegram/
Bot Telegram completo usando a biblioteca go-telegram/bot
WhatsApp
playground/whatsapp/
Integração via whatsmeow
Cenários de chat
playground/chat_scenarios/
Runner de cenários de conversa para testes automatizados
Testes
# Executar todos os testes
go test ./...

# Executar com detector de corrida
make test

# Executar um pacote específico
go test ./internal/agent/...
go test ./internal/streaming/...
go test ./internal/handlers/...
Solução de Problemas
Tool calls não acontecem modelo descreve uma ação em vez de executar:
Verifique native_tool_caller para o provider ativo.
Confirme que os caminhos de tool_prompt e schema_template estão corretos e os arquivos existem.
Aumente log_level para debug e inspecione o prompt completo enviado ao LLM.
RAG não injeta contexto:
Confirme rag.enabled = true.
Verifique a conectividade com o Qdrant (qdrant_url).
Confirme que llm_routing.default_embedder aponta para um provider que declara a capacidade embedder.
Verifique rag_chunks_loaded em /health se for 0, a indexação falhou no startup.
Requisições encerrando por timeout:
Aumente server.write_timeout (deve ser ≥ server.request_timeout).
Se usar balanceamento de carga, load_balancing.timeout deve ser menor que server.request_timeout.
Tool Python falha ao iniciar:
Confirme que tools.toolpacks_dir está correto e contém _pool_worker.py na raiz.
Valide cada manifest.json (campos obrigatórios: name, description, runtime, entrypoint, schema).
Confirme que python3 (ou TOOLPACKS_PYTHON_BIN) está no PATH.
Tool Python falha durante a execução:
O stderr do subprocesso Python é encaminhado para o log do processo Go.
Confirme que a tool escreve JSON válido em stdout e usa stderr apenas para erros.
Verifique se as variáveis de ambiente exigidas pela tool estão definidas.
Respostas idênticas repetidas (cache hit inesperado):
Verifique cache_hit no corpo da resposta ou o header X-Cache-Hit.
Ajuste cache.response_ttl_interval ou varie o conteúdo do histórico para contornar o cache.
/health/ready retorna 503:
Todos os providers configurados falharam em 100% das requisições desde o startup.
Verifique provider_health em /health para identificar qual provider está com erro e qual é a mensagem (last_error).
Causas comuns: chave de API inválida, provider fora do ar, limite de taxa atingido sem recuperação.
O probe volta a 200 automaticamente assim que qualquer provider completar uma requisição com sucesso.
POST /knowledge/ingest retorna 422 (dimension mismatch):
O modelo de embedding foi trocado após a criação da coleção Qdrant.
Apague a coleção Qdrant e reinicie o agente (re-indexação ocorre no startup com qdrant_reindex_on_boot = true).
POST /knowledge/ingest retorna 500:
Verifique se rag.enabled = true e o agente está conectado ao Qdrant.
Confirme que o provider embedder está disponível e declara a capacidade embedder.
Alta taxa de erro em /health para um provider:
O mapa provider_health mostra error_rate_pct e last_error por provider.
A lógica de retry trata erros transitórios automaticamente (2 retentativas, backoff exponencial a partir de 500 ms).
Erros persistentes indicam problema de configuração ou chave de API inválida.
Segurança
Use substituição de variáveis de ambiente ou um gerenciador de segredos em produção nunca commite o config.yml com chaves reais.
O servidor MCP suporta autenticação Bearer via mcp.token; habilite-a em ambientes expostos.
O pool de workers Python executa scripts do toolpacks_dir; certifique-se de que esse diretório não seja gravável por usuários não confiáveis.
O middleware de rate limiting protege /chat e /chat/stream contra abuso por IP.
N
Nexus Agent
raykavin·2 顆星·
Multi-provider LLM agent backend with RAG, Python toolpacks, SSE streaming and MCP server. Supports OpenAI, OpenRouter and Ollama with per-session routing, tool-calling loop and OpenTelemetry observab