
<a href="https://modelcontextprotocol.io/"></a>
<a href="https://github.com/jlowin/fastmcp"></a>
<a href="LICENSE"></a>
<a href="https://github.com/Kuhakucai/douyin-mcp/stargazers"></a>
第一次接触开源、编程或 MCP?可以先看新手教程:只要会给 Agent 下指令,直接把一句话发给 Agent,让它完成安装和配置。
[!IMPORTANT] 这是非官方社区工具。 本项目未获抖音或其关联公司授权、认可或背书。项目使用 Playwright 操作浏览器;即使只读取本人账号中真实可见的数据,也可能违反平台条款或触发账号风控。使用前请阅读平台合规与非官方声明,确认已取得所需授权,并先执行风险确认。AGPL 只许可项目代码,不授予任何平台访问权、数据权或商标权。
一分钟了解
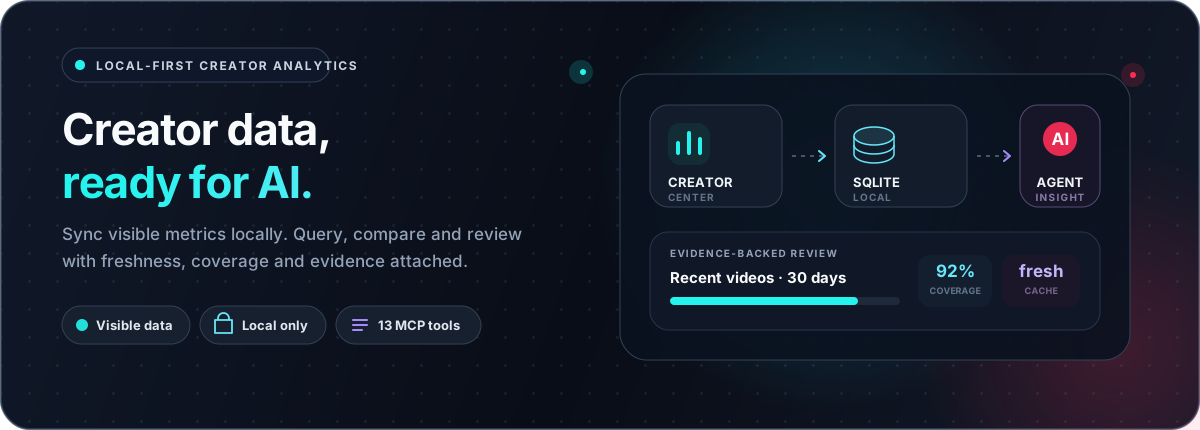
douyin-mcp 在你的电脑上复用专用 Chrome 登录状态,将抖音创作者中心页面中真实可见的作品、经营指标和公开视频音轨文案保存到本地 SQLite,再通过 MCP 提供给支持 MCP 的 AI Agent。AI 不仅能看到“这条视频表现如何”,还能结合“视频具体讲了什么”进行分析和复盘。
它解决的是一个具体问题:
抖音创作者中心(指标 + 公热视频音轨) → 本地结构化数据 → MCP → AI Agent
视频文案采用按需加载,而不是首次启动就批量处理全部历史视频。这样能更快完成首次同步,减少不必要的媒体下载、CPU 占用和本地存储;当用户真正分析某条视频时,缺失文案会自动进入后台提取队列。
当前范围为 macOS 或 Windows、本机运行、单用户、单抖音账号。本项目不提供多账号托管、云端采集、数据转售、未公开接口抓取,或绕过登录、安全验证、权限及风控的能力。
快速开始
环境要求
- macOS 或 Windows 10/11
- Python 3.11 或更高版本
- Google Chrome
- 一个支持 MCP 和终端操作的 Agent
视频文案是首次安装后的可选功能;需要时只要告诉 Agent“启用视频文案”,由它说明额外依赖、下载和磁盘占用,并在取得同意后完成配置。
推荐:让 Agent 完成安装和配置
用户只需要对 Agent 说:
帮我克隆并安装配置 https://github.com/Kuhakucai/douyin-mcp.git 项目
Agent 必须先阅读本 README,并自行完成以下步骤,而不是要求用户逐条输入命令:
- 检查 macOS/Windows、Python 3.11+ 和 Google Chrome;缺少系统级前置条件时,说明原因并先征得用户同意再安装。
- 克隆仓库后,macOS 运行
bash ./easy-install.sh;Windows 运行powershell -ExecutionPolicy Bypass -File .\easy-install.ps1。脚本仅创建项目专用.venv、安装基础依赖、生成.env、初始化数据库和执行诊断,不修改全局 Python 或系统 PATH。 - 不假定
douyin-mcp已在全局 PATH:macOS 使用./.venv/bin/douyin-mcp,Windows 使用.\.venv\Scripts\douyin-mcp.exe。运行doctor并确认ready=true;失败时先诊断和修复。 - 运行
init,读取输出的mcp_config。展示平台风险并取得用户明确确认后,执行acknowledge-platform-risk --yes;随后将完整的mcp_config写入用户当前使用的 MCP 客户端,包括 Codex、Claude Code、Wintful、Kiro、Cursor 或其他兼容客户端。Agent 应先识别自身所在客户端和其配置方式;无法识别时,只询问用户正在使用哪个客户端,不要求用户自行寻找配置文件。Agent 无法写入客户端配置时,应给出完整配置和明确的放置位置,不能省略本地路径或猜测配置文件。 - 配置完成后运行
login --timeout 180,打开项目专用 Chrome 让用户扫码;不得绕过登录或安全验证。扫码后保持该 Chrome 打开,不要切换账号、手动跳转页面或关闭窗口。登录后验证 MCP 连接,再同步作品列表和最近 20 条作品详情,并汇报安装、登录、同步和数据覆盖情况。 - 完成安装后必须向用户交接:说明 MCP 已连接、当前登录与数据同步状态;用简明语言说明可查询作品和指标、比较作品表现、分析内容表现、导出数据等功能;给出 3 个可直接发送给 Agent 的首选示例请求。用户未启用视频文案时,明确说明音轨文案分析暂不可用,并提示用户可在需要时说“启用视频文案”。
- 初次安装不启用视频文案,也不安装 FFmpeg、ASR 模型或其他系统软件;仅当用户明确要求“启用视频文案”时,才说明下载量、磁盘占用和系统改动并征得同意。
[!NOTE] 首次扫码登录、写入 MCP 客户端配置或同步真实数据前,Agent 必须先展示平台风险并取得你的明确确认。
备用:手动安装
git clone https://github.com/Kuhakucai/douyin-mcp.git
cd douyin-mcp
python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install -e .
Copy-Item .env.example .env
douyin-mcp init
douyin-mcp doctor
也可以在已克隆的项目中运行一键脚本:
powershell -ExecutionPolicy Bypass -File .\easy-install.ps1
git clone https://github.com/Kuhakucai/douyin-mcp.git
cd douyin-mcp
bash ./easy-install.sh
推荐用法
日常使用时,建议先检查缓存新鲜度,再决定是否打开浏览器同步:
检查我的抖音数据状态。只在缓存过期时更新作品列表和最近 20 条详情;
然后按最近 30 天比较完播率、5 秒完播率和互动率,给出复盘结论。
每条结论都说明数据时间、覆盖率、缺失项和对应作品证据。
也可以直接提出具体问题:
- “找出最近 30 天互动率最高的 5 条作品,并说明共同点。”
- “对比这 3 条视频的完播率、收藏率和涨粉表现。”
- “结合这 3 条视频的音轨文案和表现数据,对比选题、开头钩子、内容结构、行动价值与互动差异;缺少文案时自动补齐。”
- “提取这条视频的教程步骤和关键结论,并标注对应时间段。”
- “哪些作品值得做续集?说明排序依据和数据局限。”
- “导出全部历史快照为 JSON。”
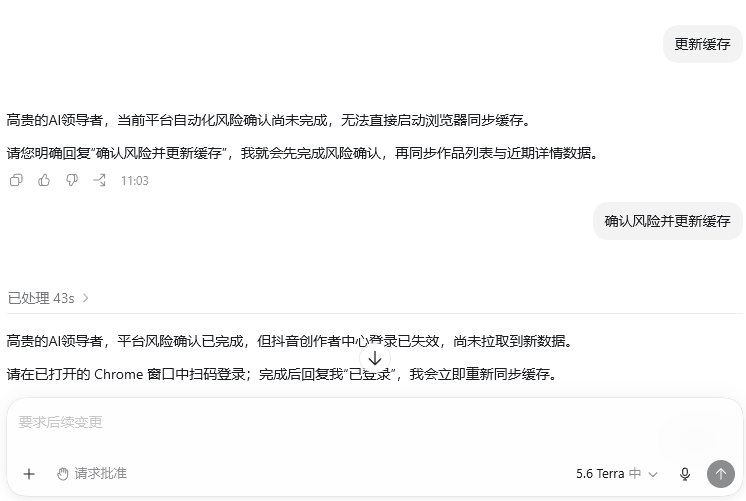
示例如下:
-
分析作品
-
更新缓存
核心能力
获取真实可见的数据
- 首次使用或登录失效时打开可见 Chrome,由用户扫码或完成安全验证。
- 后续复用项目专用浏览器 profile,通常不需要重复登录。
- 增量读取虚拟滚动作品列表,保存播放、点赞、评论、分享和收藏等页面可见指标。
- 按需分批读取作品详情,采集完播率、5 秒完播率、平均观看时长、曝光和涨粉等页面可见指标。
查询、对比与复盘
- 查询作品列表、单条作品表现和历史快照。
- 对比 2~20 条作品的关键指标。
- 从视频音轨文案中识别选题、内容结构、关键观点、教程步骤和行动价值。
- 分析或对比所需文案尚未入库时,自动创建后台任务,完成后继续分析。
- 计算点赞率、收藏率、评论率、分享率、播放率和互动率。
- 使用透明、带版本的规则进行轻量潜力排序。
- 生成带数据时间、覆盖率、缺失项和证据引用的复盘上下文。
- 导出 JSON 或 CSV,便于进一步分析或备份。
判断结论是否可信
- 返回缓存新鲜度、字段覆盖率、缺失原因和质量警告。
- 页面未显示的值保存为
null,不会用 0 或猜测值填充。 - 列表与详情分别保存为快照,不会混写数据来源。
- 派生比率只使用同一原始快照中的分子和分母,并记录公式版本。
- 首次成功同步后绑定当前账号,检测到误切账号时拒绝写入。
视频文案提取:用到时再加载
这里的“视频文案”指视频音轨中实际说出的内容,不是作品标题、发布描述或画面 OCR。MCP 获取用户本人账号中可访问的公开视频媒体,在本地提取音轨并通过本地 ASR 模型生成原始文本和时间戳分段。
启用视频文案
需要时只要对 Agent 说:
启用视频文案,并告诉我需要下载什么、会占用多少磁盘空间和会对系统做哪些改动;得到我的确认后再安装。
Agent 应检查或安装 FFmpeg、FFprobe 和 faster-whisper 可选依赖,准备本地兼容模型目录,更新项目 .env,重新生成 MCP 配置并验证文案能力。模型和运行时不会在普通安装或业务请求中被隐式下载。
为什么不在首次启动时提取全部视频
作品元数据通常可以较快同步,而文案提取需要逐条获取媒体并执行本地语音识别。首次启动就处理全部历史视频,会明显延长等待时间并占用更多 CPU、磁盘和浏览器资源。因此启用文案能力后,默认使用混合策略:
用户如何使用
通常不需要记忆工具名称,直接向 Agent 描述目标即可:
提取这条视频的完整音轨文案,保留时间戳分段;如果尚未入库,
创建后台任务并持续查询,完成后把完整内容展示给我。
结合这 3 条视频的音轨文案和表现数据,对比选题、开头钩子、
内容结构、关键观点、行动价值与互动差异;缺少文案时自动补齐。
先估算提取全部历史公开视频文案需要的数量、时间和存储空间,
不要立即执行,等我确认后再开始。
按需任务会先返回 run_id。Agent 可查询任务直到出现以下结果:
analysis_ready:文案已入库,可以读取完整文本、时间戳分段和分析上下文。no_speech:任务成功,但音轨中没有检测到可用语音。failed:媒体获取、环境或 ASR 处理失败;应先查看错误原因,再决定是否重试。
使用边界
- 只处理当前账号中可访问并被识别为公开视频的作品,不绕过登录、权限或平台验证。
- 原始 ASR 文本可能存在专有名词、英文缩写和同音词误识别;分析时保留原文,展示前可另做纠错和分段。
- 文案提取关注音轨语音,不分析画面内容,也不保证识别背景音乐、无声字幕或画面文字。
- 分析过程中不需要持续播放完整视频;媒体获取完成后,音轨处理和 ASR 在本地后台执行。
- 默认单 worker 处理,优先保证稳定性;不要通过提高并发绕过平台风控或本机资源限制。
高级参考
CLI
以下命令中的 douyin-mcp 是简写:macOS 请使用 ./.venv/bin/douyin-mcp,Windows 请使用 .\.venv\Scripts\douyin-mcp.exe。也可以先激活对应的 .venv,再直接运行 douyin-mcp。
常用命令:
# 首次登录或登录失效
douyin-mcp login --timeout 180

# 同步作品列表
douyin-mcp sync

# 查看作品并取得 video_id
douyin-mcp videos --limit 20

# 每批最多处理 10 条;根据 next_cursor 继续
douyin-mcp details --recent-limit 20
douyin-mcp details --recent-limit 20 --cursor 10

# 查询单条作品表现
douyin-mcp performance <video_id> --period 30d

# 查看登录、缓存、任务和覆盖率
douyin-mcp status
MCP 工具
默认入口保留原有 13 个浏览器数据工具,并新增 9 个本地视频文案流水线工具。
所有工具使用内部账号键 browser-default,Agent 无需传递账号 ID。常见业务状态包括 completed、partial、cache_hit 和 user_action_required。
文案流水线配置
视频文案能力默认关闭。请先完成视频文案提取:用到时再加载中的依赖与模型配置,再设置 TRANSCRIPT_INGESTION_ENABLED=true。运行时不会联网下载模型。
MCP 提交只创建持久 run 并立即返回;后台 worker 按视频复用全局 job。同一视频已有可用文案时会直接复用,不会重复获取和转写。analysis_ready 和 no_speech 都是成功终态,标点恢复或语义分段不会阻塞分析。
启用后默认采用混合策略,而不是首次启动就处理全部历史视频:
对应配置为:
TRANSCRIPT_AUTO_WARMUP_ENABLED=true
TRANSCRIPT_WARMUP_RECENT_LIMIT=5
TRANSCRIPT_AUTO_INGEST_NEW_VIDEOS=true
TRANSCRIPT_AUTO_NEW_VIDEO_LIMIT=20
TRANSCRIPT_AUTO_PREPARE_ANALYSIS=true
TRANSCRIPT_INGESTION_ENABLED=false 时,上述自动策略全部不会启动。命令行
douyin-mcp sync 只负责同步作品列表;需要后台预热和自动补齐时,应让保持运行的
MCP Server 调用 douyin_browser_sync_creator_data 或
douyin_browser_sync_if_needed。用户无需直接调用工具;推荐指令、任务状态和全量回溯方法已在上方视频文案章节说明。
文案分页固定到不可变 revision,游标在进程重启后仍有效;默认只返回标题、时长和 带时间戳分片。签名媒体 URL、Cookie、Authorization、媒体二进制和绝对本地路径 不会进入 MCP 响应或持久错误。
工作原理
浏览器操作、数据结构化和 Agent 推理被分成三个清晰层次:
- 浏览器层:Playwright 操作项目专用 Chrome,读取用户在创作者中心页面中真实可见的内容,不能绕过登录、权限或平台验证。
- 数据层:本地服务将页面内容规范化为作品、指标快照、同步任务和质量状态,并保存到本机 SQLite。
- MCP 层:FastMCP 暴露同步、查询、对比和复盘工具,Agent 不需要直接操作 Cookie 或理解页面 DOM。
MCP Client / Agent
        │ stdio
        ▼
douyin_creator_mcp.server
        │
        ├── BrowserExecutor ─ Playwright ── 专用 Chrome profile
        ├── TranscriptCoordinator ─ FFmpeg / local ASR
        └── Database ────────────── data/douyin.sqlite
列表同步负责发现作品和采集列表页指标,详情同步按批次访问作品详情页。两种来源分别保存为快照,不会互相覆盖。
数据可靠性
- 页面显示什么就保存什么;未显示的值为
null,不会用 0 或推测值填充。 - 写入详情前校验作品身份;无法确认时拒绝写入。
- 同一批次、同一作品、同一来源只写一个快照;失败同步不会覆盖历史可信快照。
period=30d等周期按快照采集时间筛选,all表示全部本地历史。- 部分作品可能被平台标记为暂不支持详情数据,此时返回
partial、失败原因和续跑游标。 - 潜力排序在样本少于 10 条时仅供参考,不代表平台官方评分。
- 页面 DOM、字段可见性和风控策略可能变化,使用时应关注覆盖率和质量警告。
登录态、账号与并发
- 登录状态保存在
data/browser-profile/,再次启动通常不需要重新扫码。 - 首次成功列表同步会基于作品标题和发布时间摘要建立不可逆账号指纹,不保存昵称、原始标题或作品 ID 作为身份信息。
- 检测到账号变化时返回
account_mismatch并拒绝写入。 - 同一 profile 同时只允许一个同步进程;死亡进程留下的锁会在安全确认后自动恢复。
- 确认要更换账号时,运行
douyin-mcp purge --yes,然后重新登录和同步。
本地数据与隐私
data/
├── browser-profile/    # 专用 Chrome 登录状态
├── douyin.sqlite       # 作品、指标快照和同步任务
├── media/               # 通过校验的本地转写源(不通过 MCP 返回)
├── staging/             # 可恢复阶段的临时文件
├── exports/            # JSON/CSV 导出
├── reports/            # 本地复盘产物
└── logs/
以上目录、数据库、备份和浏览器诊断产物均被 .gitignore 排除,请勿使用 git add -f 提交。
MCP 不会把 Cookie、localStorage、sessionStorage、验证码或账号密码返回给 Agent。但作品信息以及你主动查询的创作数据会进入 Agent 上下文;如果 Agent 使用云端模型,还应遵守对应模型服务的数据政策。
导出与清除:
douyin-mcp export --format json --period all
douyin-mcp export --format csv --period 30d

# 不带 --yes 时只显示确认提示
douyin-mcp purge
douyin-mcp purge --yes
[!CAUTION]
purge --yes会删除数据库、数据库备份、导出、报告和专用浏览器 profile,此操作不可恢复。
常见问题
激活虚拟环境:
.\.venv\Scripts\Activate.ps1
或者直接运行:
.\.venv\Scripts\douyin-mcp.exe doctor
下面的执行策略只作用于本次命令:
powershell -ExecutionPolicy Bypass -File .\easy-install.ps1
保持项目专用 Chrome 打开,完成扫码、验证码或安全验证,再重试同步。不要使用日常 Chrome profile 替换项目专用 profile。
另一个同步进程仍在使用专用浏览器。等待它结束后重试;如果原进程已经退出,锁会在安全确认后自动恢复。
查看 failures、coverage 和 next_cursor。常见原因包括作品暂不支持详情、页面未展示某项指标,或当前批次仍需继续。
先让 Agent 调用 douyin_browser_get_transcript_capabilities。重点检查:
TRANSCRIPT_INGESTION_ENABLED是否为true- 是否安装了
.[asr]可选依赖 TRANSCRIPT_ASR_MODEL_DIR是否指向有效的本地模型目录ffmpeg和ffprobe是否可以执行
修改 .env 后应重新运行 douyin-mcp init,更新 MCP 客户端配置并新建会话。
这是按需加载的正常状态,表示该视频尚无可用文案,后台任务已经创建。不要反复提交同一视频;让 Agent 使用返回的 run_id 查询进度,任务完成后再次读取分析上下文即可。媒体获取结束后,ASR 会在本地后台执行,不需要一直播放视频。
no_speech 是成功终态,表示模型没有在音轨中检测到可用语音。纯音乐、静音、语音过短或被背景声覆盖的视频可能出现该结果。原始 ASR 也可能误识别专有名词和英文缩写;建议保留原文作为证据,在展示或报告阶段再做纠错。
维护者参考
开发环境
macOS:
git clone https://github.com/Kuhakucai/douyin-mcp.git
cd douyin-mcp
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -e .
python -m pip install pytest
cp .env.example .env
Windows:
git clone https://github.com/Kuhakucai/douyin-mcp.git
cd douyin-mcp
python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install -e .
python -m pip install pytest
Copy-Item .env.example .env
项目结构
src/douyin_creator_mcp/
├── server.py                 # 无副作用 FastMCP 构造
├── runtime.py                # 实例锁、迁移、executor/worker 生命周期
├── cli.py                    # 用户 CLI
├── config.py                 # 环境配置
├── browser/
│   ├── session.py            # Playwright 与持久化 profile
│   ├── executor.py           # 唯一同步 Playwright 所有者线程
│   ├── commands.py           # 纯值浏览器命令
│   ├── media_observer.py     # 多 representation 收敛
│   ├── extractors.py         # 列表/详情提取和规范化
│   └── profile_lock.py       # 跨进程 profile 锁
├── services/
│   ├── browser_service.py    # 同步、查询、对比、复盘和导出
│   ├── transcript_coordinator.py # 持久后台 job、lease 与恢复
│   ├── transcript_policy.py  # 首次预热、增量入队和分析按需补齐
│   ├── transcript_query.py   # revision 游标与分析上下文
│   └── metrics.py            # 派生指标与排序公式
├── storage/
│   ├── db.py                 # SQLite、迁移与备份
│   ├── transcripts.py        # run/job/asset/revision 事务仓储
│   ├── migrations/           # 有序、带校验和的不可变迁移
│   └── schemas.sql           # 数据表结构
├── content/
│   ├── media.py              # 受控下载、FFprobe 与轨道选择
│   └── asr.py                # FFmpeg 与本地 faster-whisper
└── tools/
    ├── browser_tools.py      # 原 13 个 MCP 工具契约
    └── transcript_tools.py   # 9 个文案 MCP 工具契约

easy-install.ps1              # Windows 一键安装
easy-install.sh               # macOS/Linux 一键安装
扩展原则
- 页面读取和 DOM 处理放在
browser/。 - 可测试的业务逻辑放在
services/。 - MCP 工具只做参数声明、服务调用和统一错误响应。
- 原始数据、派生指标和不同采集来源分开保存。
- 新字段必须定义缺失语义、数据来源、解析版本和测试样例。
- 不读取或返回浏览器认证材料,不接入未公开私有接口。
基础验证
以下命令可在 macOS 或 Windows 的已激活虚拟环境中运行;未激活时,请按前文的平台对应路径调用 douyin-mcp。
python -m compileall -q src
python -m pip check
douyin-mcp doctor
真实浏览器验收
涉及 DOM、指标提取或浏览器生命周期的变更,还应使用测试账号运行:
douyin-mcp doctor
douyin-mcp login --timeout 180
douyin-mcp sync
douyin-mcp details --recent-limit 5
douyin-mcp status
验收时应核对登录态复用、页面声明数量、加载数量、解析数量、重复同步幂等性、详情身份校验、覆盖率和失败原因。真实账号数据和验收产物不得提交到仓库。
安全、合规与许可
douyin-mcp 是独立维护的第三方开源项目,不是抖音、字节跳动或其关联公司的官方、授权、认证或合作产品。
抖音用户服务协议第 2.4、5.1、5.3 和 7.1 条涉及非商业许可、自动化访问、平台外处理或展示信息、向第三方提供信息以及账号处置风险。用户必须自行确认拥有合法账号、数据访问权,以及自动化访问、平台外处理或展示、向 Agent 或模型服务提供数据所需的全部书面授权。完整说明见平台合规与非官方声明。
本项目不会通过 MCP 返回 Cookie、localStorage、sessionStorage、验证码或账号密码,但作品信息和经营数据可能进入 MCP 客户端及 Agent 上下文。“本机运行”不代表业务数据一定不会离开本机。
项目基于 GNU Affero General Public License v3.0(AGPL-3.0-only)开源。AGPL 允许商业使用代码,但修改版分发及网络交互场景需要按许可证提供对应源代码。许可证不授予抖音平台访问权、数据权、商业使用平台或数据的权利,也不授予商标权。
Copyright (C) 2026 Kuhakucai。Kuhakucai 与 Puppetsho 是同一作者使用的 Git 提交身份,详见 AUTHORS.md。
参与贡献
欢迎提交 Issue 和 Pull Request。开始前请阅读: