
番茄雷达 Fanqie Radar
番茄小说榜单 · 扫榜选书工作台 · MCP Server · 开源 Agent Skill —— 复制一个「懂网文选书的 AI 编辑」到你的写作工作流 零配置、零第三方运行时依赖,纯 Python 标准库。开箱自带当天完整真实榜单快照(女频/男频 × 阅读榜/新书榜,730+ 本书),内置极速扫榜采集器,克隆即用;一键安装为 Agent Skill(Claude Code / Codex / Cursor / Trae)。
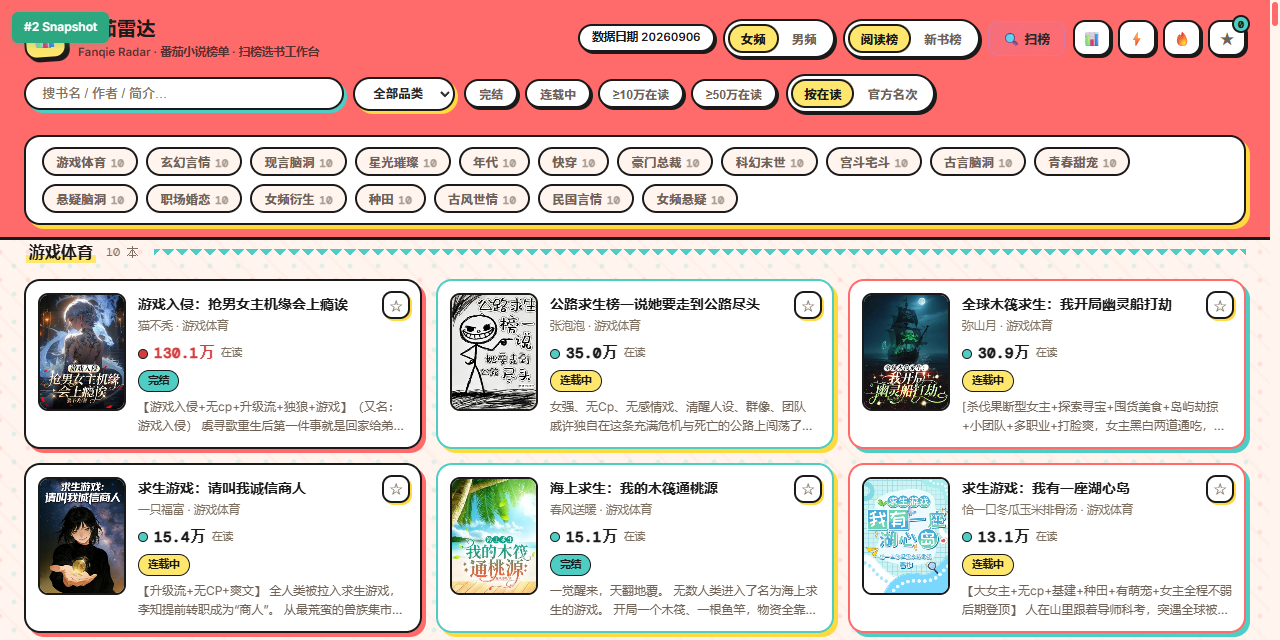
在 Claude Code / Cursor / WorkBuddy / 任意 MCP 客户端里直接问「现在女频什么火」「这本适合仿写吗」「豪门总裁赛道最近什么套路吃香」,它就答。也可以打开自带的可视化看板,像人一样翻封面、扫书名、看在读、收藏候选、追题材热度。
关键词:番茄小说 · 番茄榜单 · 扫榜 · 网文数据 · 网文选题 · 题材热度 · 仿写选书 · AI 写作 · AI 网文写作 · 网文工具包 · MCP · Model Context Protocol · MCP Server · Agent Skill · Claude Code · Codex · 数据看板 · data analysis · webnovel
它解决什么
网文作者 / AI 写作从业者天天要回答三个问题:现在什么题材火?哪本书适合仿?为什么?
市面上番茄榜单爬虫一大堆,但爬完就扔给你一堆书名。真正稀缺的是选书判断力——这本能不能仿、仿出来质量天花板在哪。本项目把方寸写作跑过真金白银验证过的六维仿写选书评分模型开源出来,并包成 MCP 服务,让你的 AI 助手直接具备这套判断力——不是拍脑袋觉得「这书很火」,而是数据驱动地告诉你「这书为什么值得仿、怎么仿」。
差异化(为什么值得装)
评分模型是核心资产,不是拍脑袋的硬规则——维度权重、阈值都来自实测反馈(详见下方「评分模型」)。
三条红线(开源版铁律)
- 核心库不内置版权正文。 包内附的是公开榜单元数据快照(书名/作者/在读/分类/封面,采集自番茄小说公开榜单页);不提供、不内嵌任何小说正文。真实数据可随时用自带采集器刷新,见下方「扫榜采集」。
- 不提供「下载整本小说」能力。 MCP 只返回
book_id/url,让你自己去处理。 - MCP 对外投影不返回
intro简介全文 /cover版权图 URL(书目只含:book_id、标题、作者、品类、在读、状态、章节数、url)。本地看板点击书名可看简介——渲染的是用户本地自有快照,按需单本拉取,不经仓库分发、不进 MCP。
快速开始(零配置)
1. 安装
git clone https://github.com/WindXRan/fanqie-radar.git
cd fanqie-radar
pip install .           # 需要 Python >= 3.10,零第三方依赖
不装包也能直接跑:python -m fanqie_index.mcp_server。
2. 直接用(什么都不用配)
开箱即带当天完整真实快照(女频/男频 × 阅读榜/新书榜,730+ 本书)——克隆下来就能跑通全部工具和看板:
fanqie-radar            # MCP stdio 服务,直接挂客户端
fanqie-radar-web        # 可视化看板,浏览器打开 http://127.0.0.1:8401
3. 换上你的真实数据
把你的榜单快照放进 ./data/ 目录(或任意目录,设 FANQIE_INDEX_DATA_DIRS 指过去)。命名规范见下方「数据格式规范」。
3.5. 扫榜采集(内置 · 零依赖 · 1 分钟刷新全站)
内置采集器直接解析番茄小说公开榜单页(HTTP 请求 + 页面数据提取,标准库 urllib,无 Playwright、无浏览器、零第三方依赖),把数据保存为本地 JSON 快照。全站 4 个榜(女频/男频 × 阅读榜/新书榜,74 个分类)仅需约 1 分钟。
看板一键采集(推荐):打开看板 → 点击顶栏「🔍 扫榜」→ 点「开始采集」,进度实时滚动,完成后看板自动刷新——全程无需终端。
命令行采集(进阶):
fanqie-radar-scrape                      # 采集全部 4 个榜(约 1 分钟)
fanqie-radar-scrape --gender female --rank read  # 只采集女频阅读榜
fanqie-radar-scrape --limit 30 --sleep 1  # 控制每分类上限和间隔(秒)
采集的数据自动保存到 ./data/ 目录。合规设计:固定延迟(默认 1s/分类)、User-Agent 轮换、只采集公开榜单元数据、数据存本地不上传。
4. 挂到 MCP 客户端
Claude Desktop(claude_desktop_config.json):
{
  "mcpServers": {
    "fanqie-radar": {
      "command": "fanqie-radar"
    }
  }
}
零配置即可挂载(跑在示例数据上);要分析自己的数据,加一个 env 指向快照目录:
"env": { "FANQIE_INDEX_DATA_DIRS": "C:/path/to/your/data" }
Cursor / 其他:同样指向 fanqie-radar 命令(或 python -m fanqie_index.mcp_server)。多目录用 ; 分隔(Windows)/ :(Linux/macOS)。
5. Agent Skill(Claude Code / Cursor / Trae 等智能体一键接入)
本仓库自带 Agent Skill(skills/fanqie-radar/SKILL.md),让 AI 自动启动服务、调用 API/工具,同样零配置。
一键安装(推荐):
方式一 · 生态标准 npx skills(复制命令即可,已实测验证):
npx skills add WindXRan/fanqie-radar --skill fanqie-radar --agent claude-code codex --global --yes --copy
#                                                                    ↑ 可换 cursor / trae / etc,多个用空格分隔
方式二 · 自带 CLI(零依赖、纯标准库):
pip install .                       # 装好自带 fanqie-radar-skill-install 命令
fanqie-radar-skill-install          # 交互式:选客户端 + 范围,一键装进技能库
# 常用:
fanqie-radar-skill-install --agent claude-code --global   # 装到 Claude Code 全局
fanqie-radar-skill-install --agent all --global           # 装到所有 8 个客户端
fanqie-radar-skill-install --agent cursor --local         # 仅装到当前项目
fanqie-radar-skill-install --list                         # 先看仓库内置了哪些
npx skills 支持 Claude Code / Cursor / Codex / Trae 等主流客户端(--agent 可多选,用空格分隔);自带 CLI 支持 Claude Code / Cursor / Trae / GitHub Copilot / Cline / Gemini CLI / Codex / OpenCode(--agent all 一次全装)。装完重启客户端生效。
可视化看板(引流门面)
孟菲斯风格(Memphis Design)暖杏工作台:珊瑚粉顶栏 × 墨线描边 × 彩色硬阴影 × 波点锯齿 × 胶囊按钮——把冷冰冰的数据做成年轻化的选书工具。零依赖、纯原生(无 CDN、无框架、无第三方库),一把 Python 标准库 + 一个 HTML 文件撑起整张门面,也是开源引流的主战场。
fanqie-radar-web --data <你的数据目录> --port 8401
# 浏览器打开 http://127.0.0.1:8401(不传 --data 则自动用包内快照)
看板包含:
- 固定顶栏:品牌 / 女频·男频 × 阅读榜·新书榜四宫格切换 / 快筛工具条 / 品类快跳条——整条 sticky,下滑不消失,换榜筛选随时可用
- 书卡流(主视图,全宽三列):封面 / 书名 / 作者·品类 / 在读大字(量级分色)/ 徽章(完结·章节数·套路命中)/ 简介前两行;品类分组小节标题 + 骨架屏 + 级联入场
- 右侧抽屉(顶栏按钮呼出,Esc/遮罩关闭):
- 📊 题材热度 —— 各品类在读量对比条,一眼看赛道谁在吸量
- ⚡ 今日动静 —— 新上榜 / 掉出榜(对比同榜两份快照)
- 🔥 热词榜 —— 点词筛同套路书
- ★ 候选清单 —— 点 ☆ 收藏(localStorage 持久化),顶栏按钮带数量角标
- 人类动线:点书名看完整简介 → 点热词筛同套路书 → 点题材热度条筛品类 → 收藏候选集中对比
- 完结 / 连载中 一键筛选 + 「≥10万/≥50万」在读门槛,快速筛掉不合适的母本
- 🔍 一键扫榜:看板内点按钮即刷新当天榜单,进度实时滚动,采完自动重渲
- 广告位:主区横幅 + 抽屉底部各一处,放一份
web/ads.json即可自定义(仓库附示例) - 无综合评分刷屏——评分模型在 MCP 工具
fanqie_imitation_score里,看板只做「帮人扫榜」
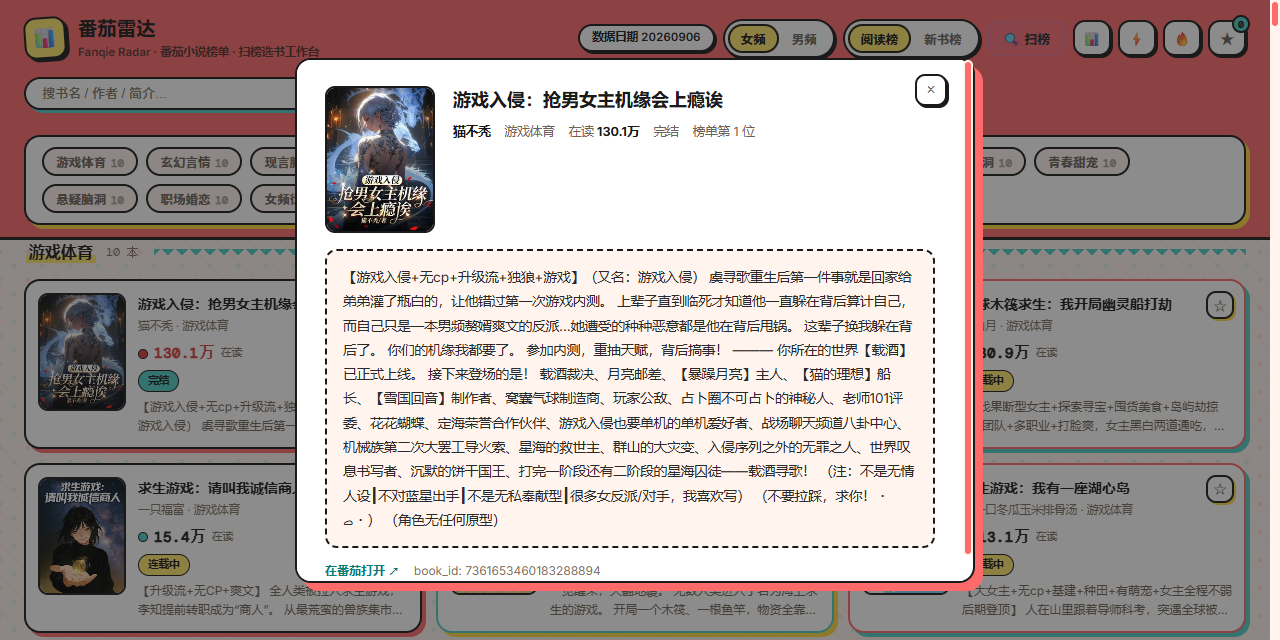
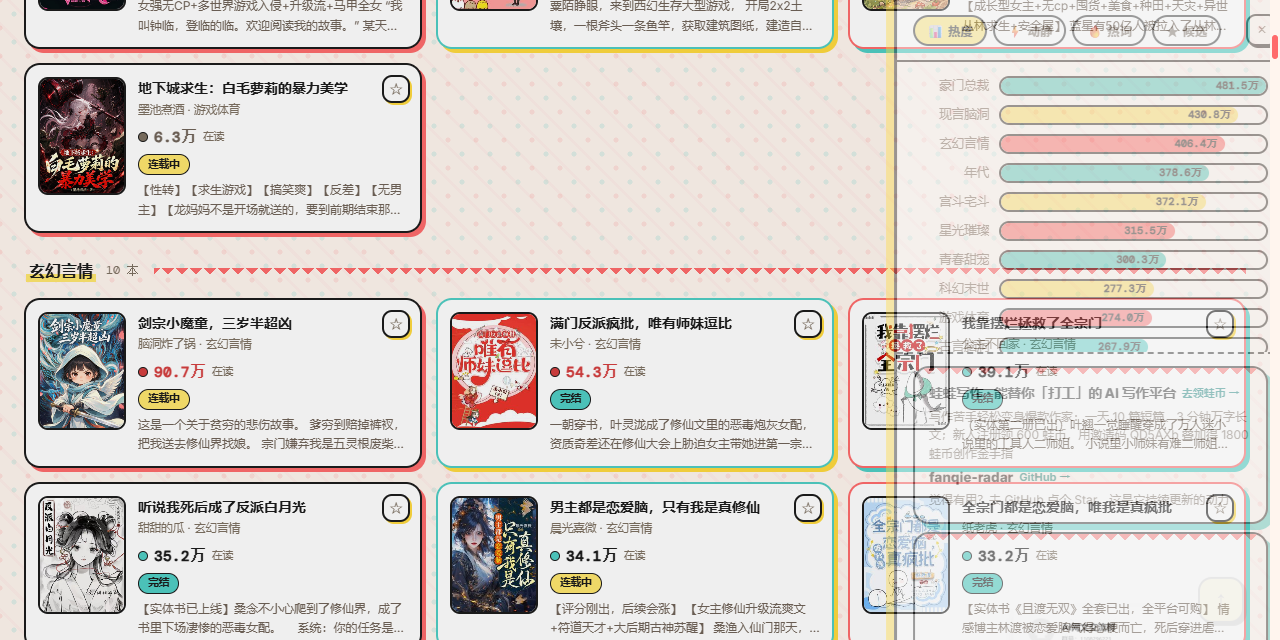
切换「女频/男频」「阅读榜/新书榜」即时重渲。web/ 目录为静态资源,src/fanqie_index/web.py 为标准库 server(静态页 + /api/* 复用内核)。
数据格式规范(接入契约)
文件名:
fanqie_{gender}_{rank}_ranks_{YYYYMMDD}.json
  gender: female | male
  rank:   read(阅读榜) | new(新书榜) | peak(巅峰榜) | completed(完结池)
文件内容(两种都兼容):
{
  "date": "20260905",
  "rank_type": "女频阅读榜",
  "categories": [
    {"name": "豪门总裁", "books": [{ "title": "...", "author": "...", "reads": "24.1万",
      "intro": "(可选)...", "url": "https://fanqienovel.com/page/123", "status": "已完结",
      "chapters": 158, "bookid": "123" }]}
  ]
}
reads支持"24.1万"/"1.2亿"/ 整数。bookid缺失时自动从url的/page/{id}提取——全量书目都可被 book_id 寻址。intro选填:有它评分更准确(套路/金手指命中),没有给中性分。chapters选填:章节数(番茄书籍页公开可获取),用于体量适配评分与看板徽章。- 也兼容平铺格式
{"books": [...], ...}(每本自带category)。
可选:章节/状态缓存(<数据目录>/meta_cache.json)——榜单快照通常不含章节/状态,
本仓库不抓取,由你自己的外部工具补全后放到数据目录即可,看板自动合并(mtime 热更新,改完即生效):
{ "<book_id>": { "chapters": 158, "status": "已完结" } }
快照缺字段时用缓存补,快照有值不覆盖。没有缓存文件看板照常工作(章节数显示 "—")。
工具清单
评分模型(六维 + 加成)
完结短书(女频主体)六维权重:
加成项(有则加,无则跳过): 持续在榜天数(≤+8,套路耐看)、新书榜命中(+6,近期起量)、跨榜(≥2 榜,+4)、巅峰榜(+8,平台月度精选,女频专属再 +4)。
男频连载母本评分(serial=true): 维度换成 连载体量 25% / 在读 25% / 更新活跃 15% / 题材吸量 15% / 套路 10% / 金手指 10%——与女频「短完结」相反,母本追求 450 章+ 连载长书 + 日更活跃。
所有阈值来自实测(如「百万字长书不作仿写源」「≈220–450 章的连载体量最优」;历史字数阈值按 2250 字/章折算为章节数),详见 src/fanqie_index/scoring.py 内各函数 docstring 的调研出处。
开发
pip install -e ".[dev]"
pytest                      # 21 个测试
结构:
src/fanqie_index/
  schema.py      榜单快照:目录探测 / 元数据解析 / 书目归一 / 查找 / 统计
  scoring.py     六维评分 + 男频连载评分(词表 + 维度函数 + 加权)
  analysis.py    题材热度 / 跨榜强信号 / 书名热词 / 多日趋势差分
  mcp_server.py  stdio MCP 服务入口(手写 JSON-RPC,零第三方依赖)
  sample_data/   包内真实榜单快照(采集日当天公开榜单元数据,零配置兜底 + 开箱即用)
examples/sample_data/   同款真实快照(仓库副本)
skills/fanqie-radar/    Agent Skill(智能体一键接入)
tests/                  pytest 冒烟测试
调试 MCP: 直接往 stdin 发 newline-delimited JSON-RPC:
python -c "
import subprocess,os,json
inp=[json.dumps({'jsonrpc':'2.0','id':1,'method':'initialize','params':{}}),
     json.dumps({'jsonrpc':'2.0','id':2,'method':'tools/list'})]
p=subprocess.Popen(['python','-m','fanqie_index.mcp_server'],stdin=subprocess.PIPE,stdout=subprocess.PIPE,encoding='utf-8',env=os.environ)
print(p.communicate('\n'.join(inp)+'\n')[0])
"
免责声明
本项目仅提供数据读取 / 分析 / 评分的工具能力。数据由使用者自行负责采集与合规,须遵守相关平台的服务条款与所在地法律法规,仅供个人学习与研究使用。本仓库不对使用者采集、持有或使用数据的行为承担任何责任。
License
MIT © 方寸写作 (FangCun Studio)